摘 要: 文章基于综合赋权和大数据技术,提出了一套系统性评价全球中文教育发展的实践方法。 研究首先构建了评价指标体系,并建立了相关数据集。 文章开发了一种结合专家主观赋权和数据驱动的综合赋权法,创新排名算法,并在研究中对其进行了验证。 基于此,文章首次计算出全球中文教育发展指数及其排名,并将全球国家划分为六种中文教育类型。 此外,通过引入外部数据集,分析了经济、地理、文化等因素与中文教育发展指数的相关性。 该研究为全球中文教育发展提供了新的研究框架和决策依据,旨在促进中文教育的高质量发展。
关键词: 全球中文教育;评价体系;综合赋权;排名算法;大数据技术
当前,作为传承语和外语的中文教育在全球180 多个国家和地区广泛开展,国际中文教育的重心逐渐从中国本土转移到海外。 在这一趋势下,“全面了解和科学评价”这些国家和地区的中文教育现状,并深入探究相关因素,以帮助制定科学的政策,促进全球中文教育事业的高质量发展,成为学界的一项新的重要使命。 要实现科学评价,需要构建完善的评价体系;要全面了解现状,需要数据资料的支持;要深入探究相关因素,则需要引入其他领域数据进行分析。
目前,在全球视野下的中文教育评价研究上,学者们初步建构了本土化发展① 郭晶:《国际中文教育本土化发展指数构建研究》,《民族教育研究》2021 年第3 期。、教学资源② 梁宇、李诺恩:《国际中文教材评价指标体系构建——基于德尔菲法和层次分析法》,《贵州师范大学学报(社会科学版)》2023 年第6 期。、教师素养①方紫帆、徐娟:《国际中文教师数字素养指标体系建构研究》,《天津师范大学学报(社会科学版)》2023 年第6 期。、孔子学院②吴应辉:《孔子学院评估指标体系研究》,《教育研究》2011 年第8 期。 ③吴才天子:《基于层次分析法的孔子学院评估指标体系研究》,《亚太教育》2016 年第36 期。 ④王辉、韩进拓:《全球孔子学院发展指数构建》,《云南师范大学学报(对外汉语教学与研究版)》2021 年第2 期。等领域的评价体系;在全球中文教育数据库的构建方面,已建成“汉语国际传播动态数据库”⑤参见全球汉语国际传播动态数据库:http:/ /hanyudb.com/home。;在基于大数据的全球中文教育研究上,学者们对孔子学院分布⑥王辉、陈阳:《基于大数据的“一带一路”沿线国家孔子学院分布研究》,《云南师范大学学报(对外汉语教学与研究版)》2019 年第1 期。、学习资源等⑦陈慧、李政泽、傅晓明:《YouTube 中文学习资源大数据分析》,《首都师范大学学报(社会科学版)》2022 年第6 期。做了初步探究。 基于已有的评价体系、数据基础和大数据技术,进一步构建全球中文教育发展评价体系,深入了解全球中文教育发展的特征和相关影响因素,已成为全球中文教育发展的必然要求。 在宏观评价研究中,为了简化和量化评价结果,通常会引入“指数”概念。 据不完全统计,全球已有超过一百万个指数⑧杨丹等:《指数全球2021》,外语教学与研究出版社××年版,第××页。。在教育领域,有高校、学科、中学生学习能力(PISA)⑨https:/ /www.oecd.org/pisa/等指数;在语言学领域,有国家语言多样性⑩https:/ /en.wikipedia.org/wiki/List_of_international_rankings、语言障碍⑪王立非、崔璨:《中国翻译》2018 年第2 期。、国家语言能力⑫张天伟:《国家语言能力指数体系的发展与比较研究》,《外语研究》2022 年第4 期。、国家翻译能力⑬任文等:《国家翻译能力研究》,商务印书馆2023 版。等指数;在语言国际教育和传播领域,有全球商务语言⑭彭博社:《汉语成全球第二大商务语言》,《孔子学院》2011 年第5 期。、英语水平⑮https:/ /www.statista.com/statistics/1187774/english-language-proficiency-index-in-cee-cis-region-by-country/、俄语全球能力等⑯李迎迎、潘晓彤:《俄罗斯国家通用语言全球能力指数研究与新探》,《天津外国语大学学报》2022 年第6 期。指数。 在全球中文教育发展评价研究中,我们也正致力于用指数来呈现各国的评价结果。
本文将尝试构建全球中文教育发展评价体系,建设相应数据集,获取全球中文教育发展指数,进行全球中文教育排名,并对全球中文教育进行分类描述,最后探究全球中文教育发展的相关影响因素,以帮助制定科学的政策,促进全球中文教育事业高质量发展。
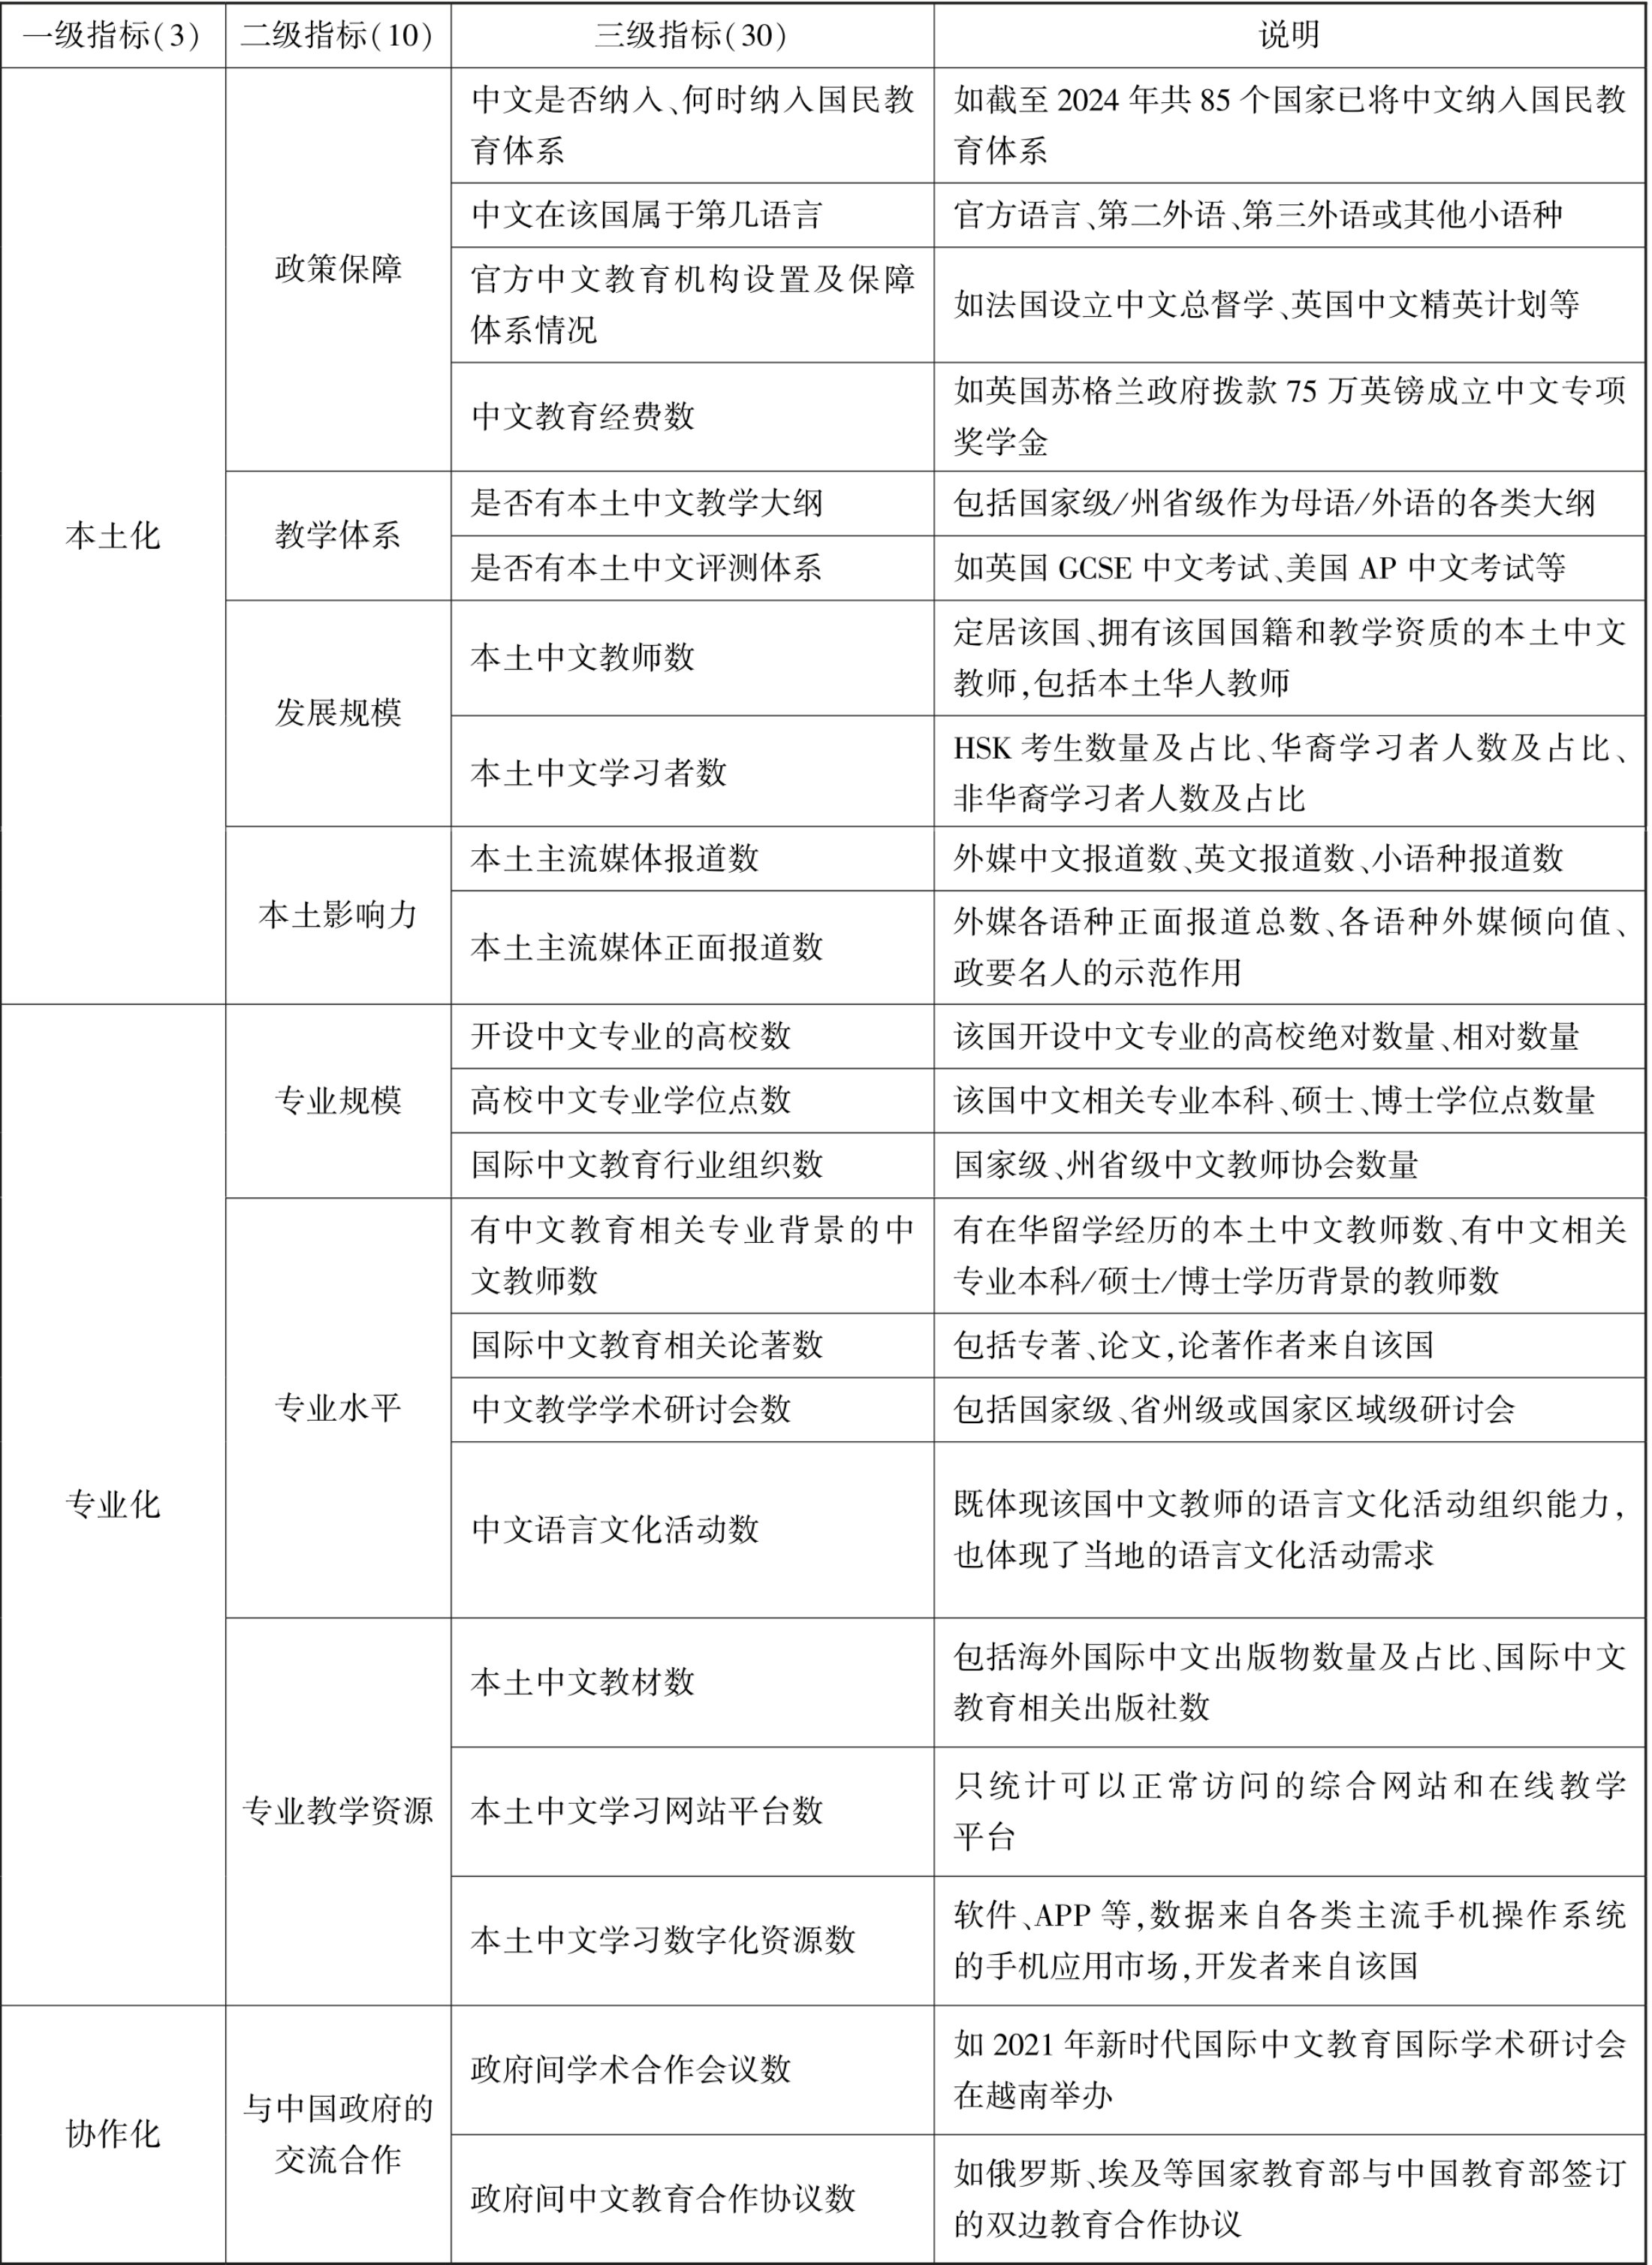
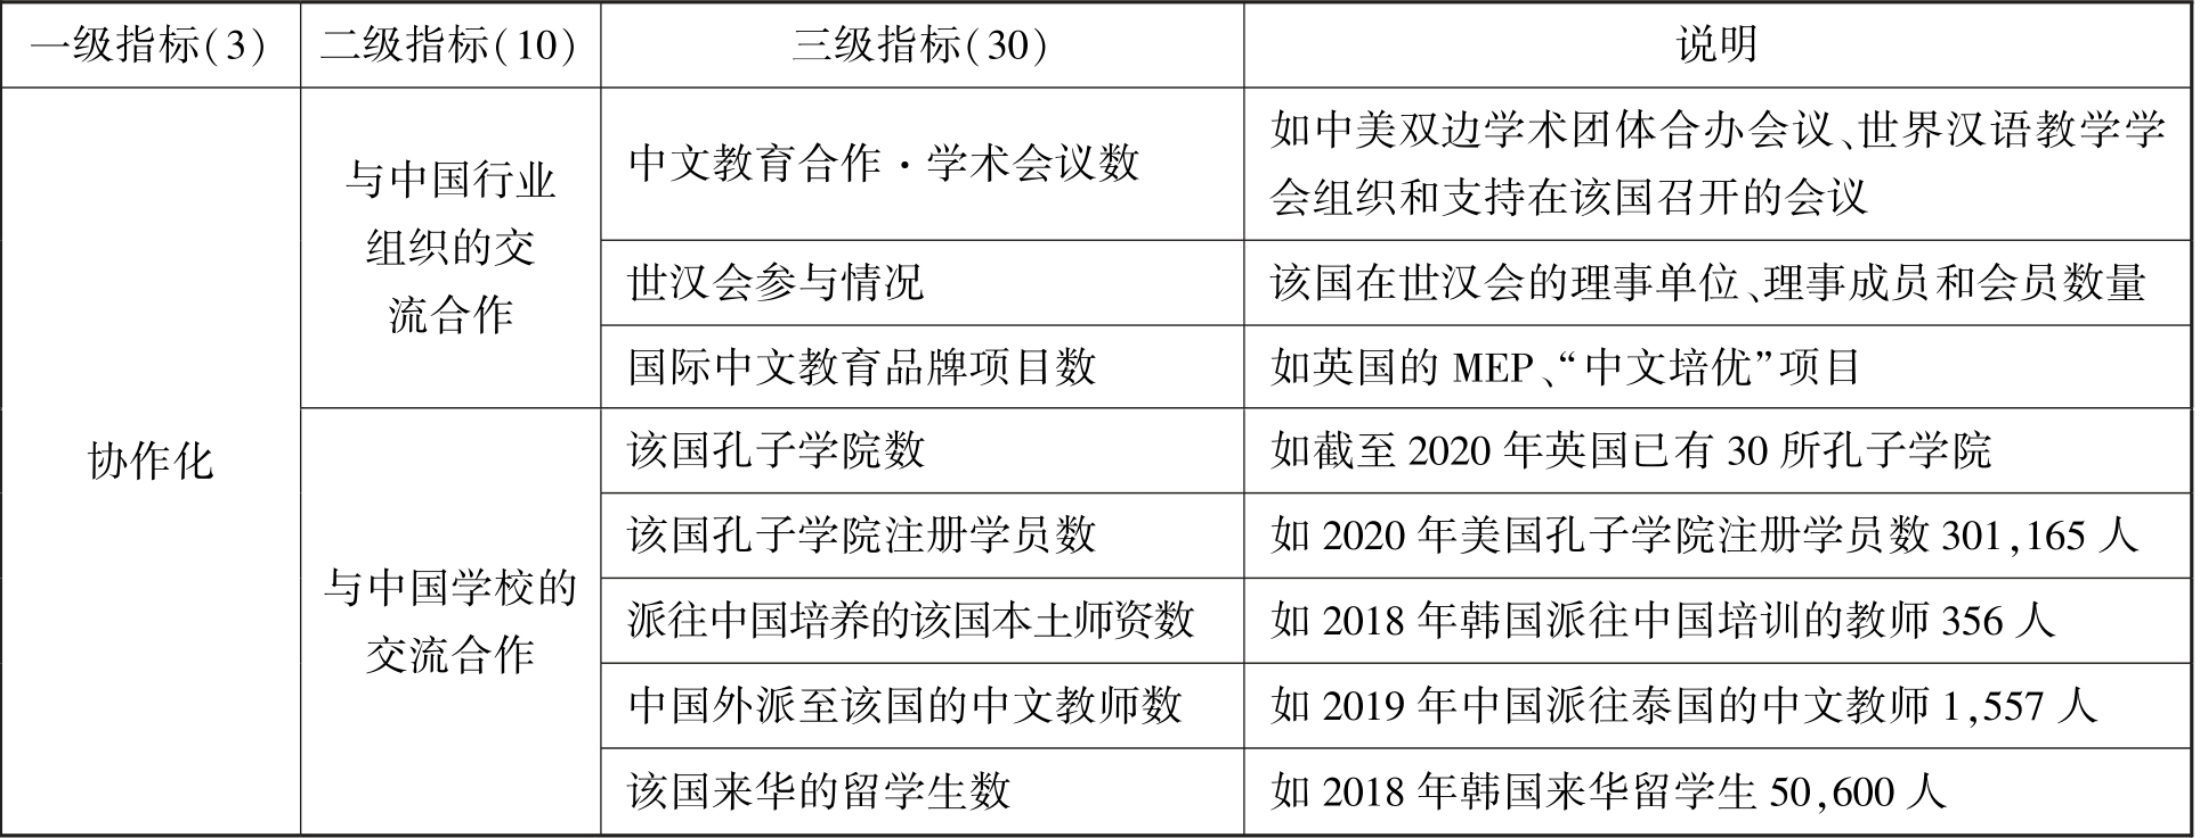
我们广泛参考评价研究、国际中文教育评价研究的重要文献,结合自上而下分类和自下而上归类两条路径,不断优化,最终建立了一个包含本土化、专业化和协作化3 个一级指标、10 个二级指标和30 个三级指标的全球中文教育发展评价体系(见表1),以上指标在评价中的权重不等。 因篇幅限制,这里仅简述评价体系构建结果,相关理论基础和建构过程将另文详述。 简而言之,本土化指标侧重展示该国中文教育独立发展的实力;专业化指标侧重评估该国中文教育工作者的专业能力;协作化指标则是量化中文母语国——中国对该国中文教育的助力。
表1 全球中文教育发展评价指标体系
续表1
目前,本评价体系仍需进一步完善。 例如,正如2023 年世界中文大会所提出的,未来国际中文教育发展的主要任务是大力发展信息化、数字化的国际中文教育⑰曹建:《丁薛祥出席2023 世界中文大会并发表主旨讲话》,新华社,http:/ /www.news.cn/politics/leaders/2023-12/09/c_1130017527.htm,2023 年12 月9 日。。 基于这一大趋势,未来可能需要增补相关指标数据,以更全面地反映全球中文教育的发展状况。
我们依托一个120 名师生组成的数据搜集团队,获得了一个涵盖153 个国家相关数据的全球中文教育发展数据集。 以下是对数据获取方法的简要说明。
作为基于数据的研究,数据的置信度、覆盖率及获取效率必须经过谨慎考量。 根据数据的可获取性,数据可以分为封闭型和开放型两类。 封闭型数据,如“孔子学院数”“是否将中文纳入国民教育体系”等,有明确的客观资料,可以对所有国家的情况进行穷尽式记录,所以其置信度、覆盖率和获取效率都很高。 开放型数据,如经费、师生人数等数据难以获取或验证。 为保证开放型数据的置信度、覆盖率和获取效率,我们通过“采样”的方法,为相关指标选择代理变量(proxy),以封闭型的代理数据来表征开放型的数据。
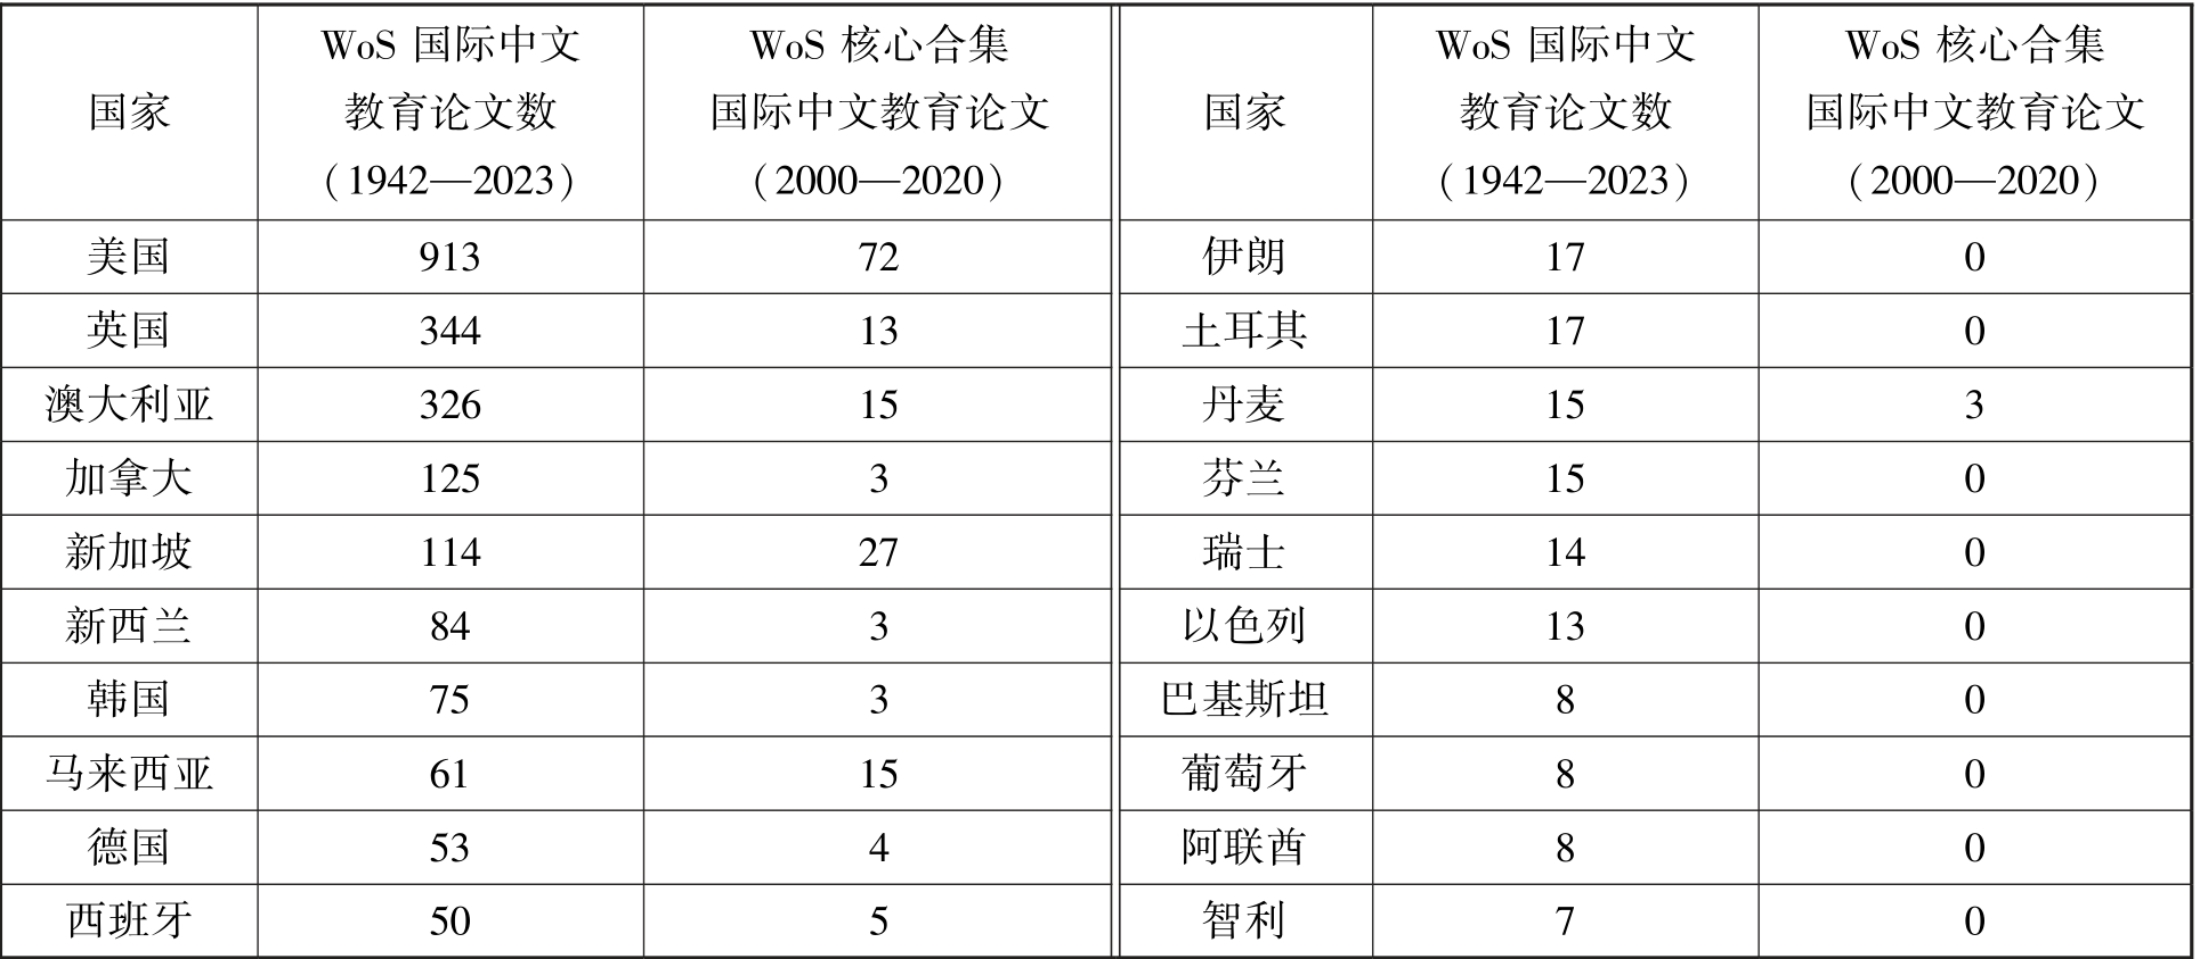
以下是我们数据获取工作的一个实例。 三级指标“国际中文教育相关论著数”是典型的开放型数据,我们选择了Web of Science① Web of Science 是全球最大、覆盖学科最多的综合性学术信息资源库。中的两个采样数据作为其代理变量,详见表2。
表2 三级指标“国际中文教育相关论著数量”的代理变量数据部分样例
根据封闭型数据和开放型数据的特点和相应搜索策略,我们基于以下数据来源构建了全球中文教育发展数据集:(1)相关机构的官方网站,如中华人民共和国外交部、各国及其省/州教育部门官方网站、各国高校官方网站;(2)官方报告,包含《国际汉语教育研究报告》、《世界汉语教育年鉴》、《国际汉语教学资源发展报告》、《孔子学院年度发展报告》、《语言教育与合作年度报告(2017—2022)》、《2021年全球指数》、《中国文化和旅游统计年鉴》(2019)、《中国对外直接投资统计公报》(2019)等;(3)相关非政府组织及专业性网站,如教育部语言交流与合作中心、中国国际教育基金会、中国国际文化协会、世界汉语教学学会、国际汉语教育人才网、UCAS.COM 等以及相关活动主办方的官方网站;(4)大型权威数据库,包括学术资源数据库和国际中文教育相关数据库,比如Web of Science、中国知网、读秀数据库、“全球汉语传播动态数据库”、北京外国语大学全球多语种教材资源中心数据库、中文全球化数据库;(5)主流信息获取平台,如主流网络媒体人民网、环球时报、新华网;主流应用商店,如苹果软件商店、Google Play、华为应用库等;权威高等教育信息网站;主要搜索引擎检索(微软必应、谷歌、百度搜索)等。
在获取较为理想的数据集之后,仍需克服以下两个挑战以用于指数计算:
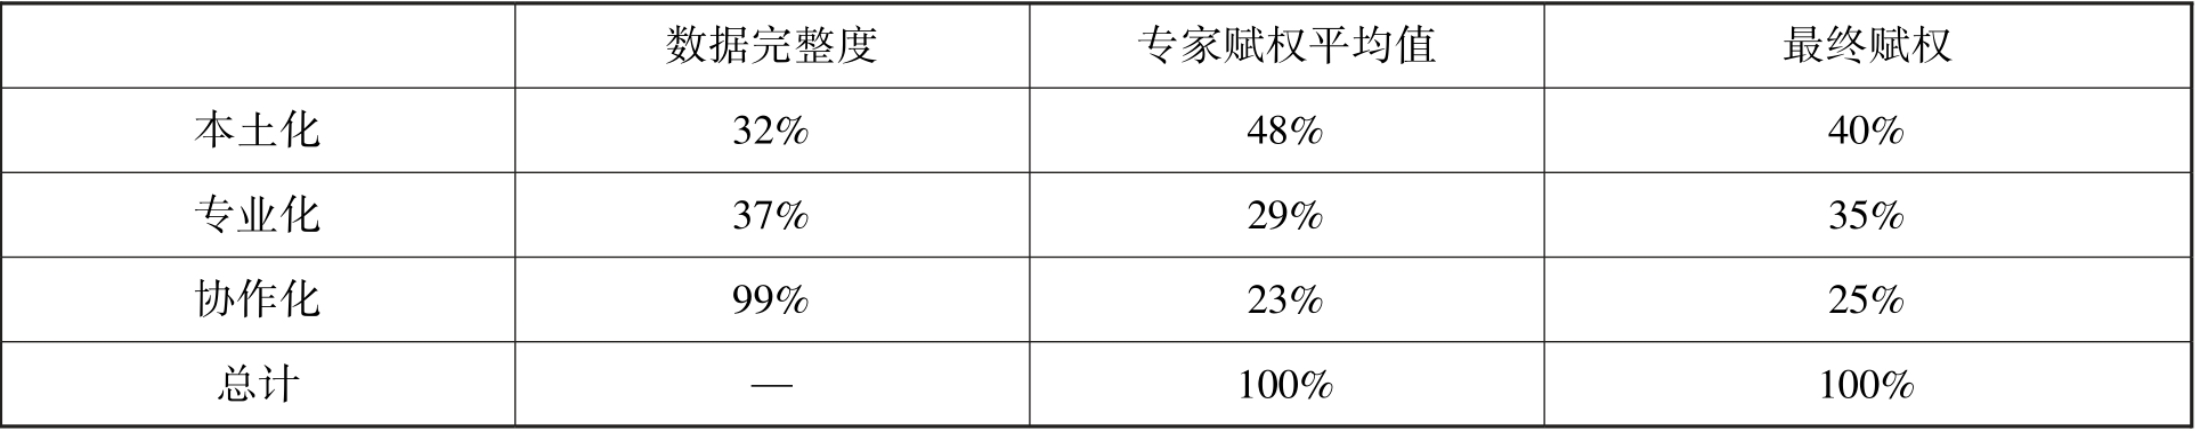
(1)数据缺失与不平衡。 由于社会科学数据采集的难度,以及各国的信息化建设水平的差异,不同指标和不同国家的开放型数据完整度存在巨大差异。 协作化的数据完整度最高,达98.7%,专业化和本土化数据完整度相对较低;从国别来看,50 个国家的数据完整度超过50%,其余100 多个国家不足50%。 因此,妥善应对数据缺失与不平衡是保证数据稳健性的关键。
(2)数据类型复杂。 目前我们的数据集囊括了多种数据类型,包括数值型(如“开设中文专业的大学数量”)、布尔型(如“中文是否被纳入国民教育体系”)、日期型(如“中文何时被纳入国民教育体系”)、字符串型(如“官方相关机构设置及保障体系情况”)和顺序型(如“中文教学大纲的级别”)数据。有效处理这些复杂的数据类型至关重要。
为解决以上挑战,我们对数据进行了如下预处理:
(1)对分布极度倾斜的原始数据进行手动分类。 如“国际中文教育学习者人数”数据,不同国家的中文学习者人数差异极大(几百人至数千万人),)我们将此数据从高到低划分为四个等级(1-4)进行统计。
(2)对布尔型数据用1 和0 表示“有/是”和“无/否”。
(3)通过最小-最大归一化将其他数据统一为0 到1 的浮点型数值型数据,以统一指标的数量级。
在指数排名中,需要给不同指标赋予不同权重,以反映其重要性和排名贡献度。 常用的指标权重设计方法分为主观赋权法和客观赋权法,各有利弊;主观赋权法能融入专家经验和知识,但存在主观性问题;客观赋权法基于数据的覆盖率、离散度等纯数据特征,自动为指标赋权,更加客观,但可能忽视指标自身的内涵。
在没有明确参照标准的情况下,我们创造性地将主观赋权法和客观赋权法相结合,提出“综合赋权法”以增强指数排名结果的公信力(算法设计细节见① Chen,H, Li,Z,& Wang,X., “On International Chinese Education Index Ranking in a Global Perspective,” Array,vol.20,no.100328, 2023.)。 首先,采用德尔菲专家调查法(Delphi method)决定一级指标权重。 我们联系了33 位国内外国际中文教育领域的知名学者,对30 个三级指标分别进行主观赋权,并采用肯德尔秩相关系数(Kendall correlation coefficient)验证专家赋权的内部相关性①肯德尔秩相关系数(Kendall correlation coefficient)是一个非参数性质(与分布无关)的秩统计参数,是用来度量两个有序变量之间单调关系强弱的相关系数,它的取值范围是[-1,1],绝对值越大单调相关性越强,取值为0 时表示没有相关性。。结果显示,专家评价的内部单调正相关性为100%。 也就是说,专家意见趋于一致。
基于专家意见,初步确定3 个一级指标的主观赋权为:本土化48%、专业化29%、协作化23%。 但由于一级指标之间数据的严重不平衡(详见表3),我们做了调整,最终的一级指标权重为:本土化(40%)、专业化(35%)和协作化(25%)。
表3 全球中文教育发展指数评价指标权重
(三)三级指标客观赋权
完成主观赋权后,进入客观赋权环节,即把一级指标本土化、专业化、协作化的权重40%、35%和25%分配落实到其对应的三级指标上,以实现三级指标赋权。 这一过程将直接影响各国中文教育指数的最终排名,因此采有数据驱动的排名算法尤其重要。
目前常见的排名算法包括排名聚合和指标加权两大类。 排名聚合通过合并多个排名方法生成更具说服力的综合排名②Li,X.,Wang,X.,& Xiao,G,“A Comparative Study of Rank Aggregation Methods for Partial and Top Ranked Lists in Genomic Applications”,Briefings in Bioinformatics, vol.20,no.1,2019,pp.178-189.,较为成熟的有波达计数法③Borda,J.-C., “M’emoire sur les’elections au scrutin,”Histoire de l’Acad’emie Royale Des Sciences,1781.、马尔可夫链方法和随机优化方法④Lin,S.,“Rank Aggregation Methods,”Wiley Interdisciplinary Reviews: Computational Statistics, vol.2,no.5,2010,pp.555-570.等。 然而,这些算法通常假定每个指标的权重相同,这显然不适用于我们的评价任务。 其次,某一指标数据的离散程度会影响自动赋权的权重,即数据分布越离散,得出的排名往往越可靠。 由于数据预处理后,初始数据通过分类或归一化趋于集中,这种传统的排名聚合方法不再适用。
指标加权法包括变异系数法(CVM)、熵权法(EWM)、CRITIC 法(通过标准间相关性确定标准重要性)和主成分分析法(PCA)等算法,为此问题提供了解决方案,但通常无法为三级指标进行二次赋权。而排名聚合法中的Perron 特征向量法(PEM)⑤Pearson,K.,“LIII.On Lines and Planes of Closest Fit to Systems of Points in Space,” The London,Edinburgh,and Dublin Philosophical Magazine and Journal of Science,vol.2,no.11,1901,pp.559-572.不仅可以胜任二次赋权任务,还可以很好地应对数据缺失和不平衡问题,使其成为我们赋权过程中的最佳选择(见表4)。
表4 主要排名算法对比分析
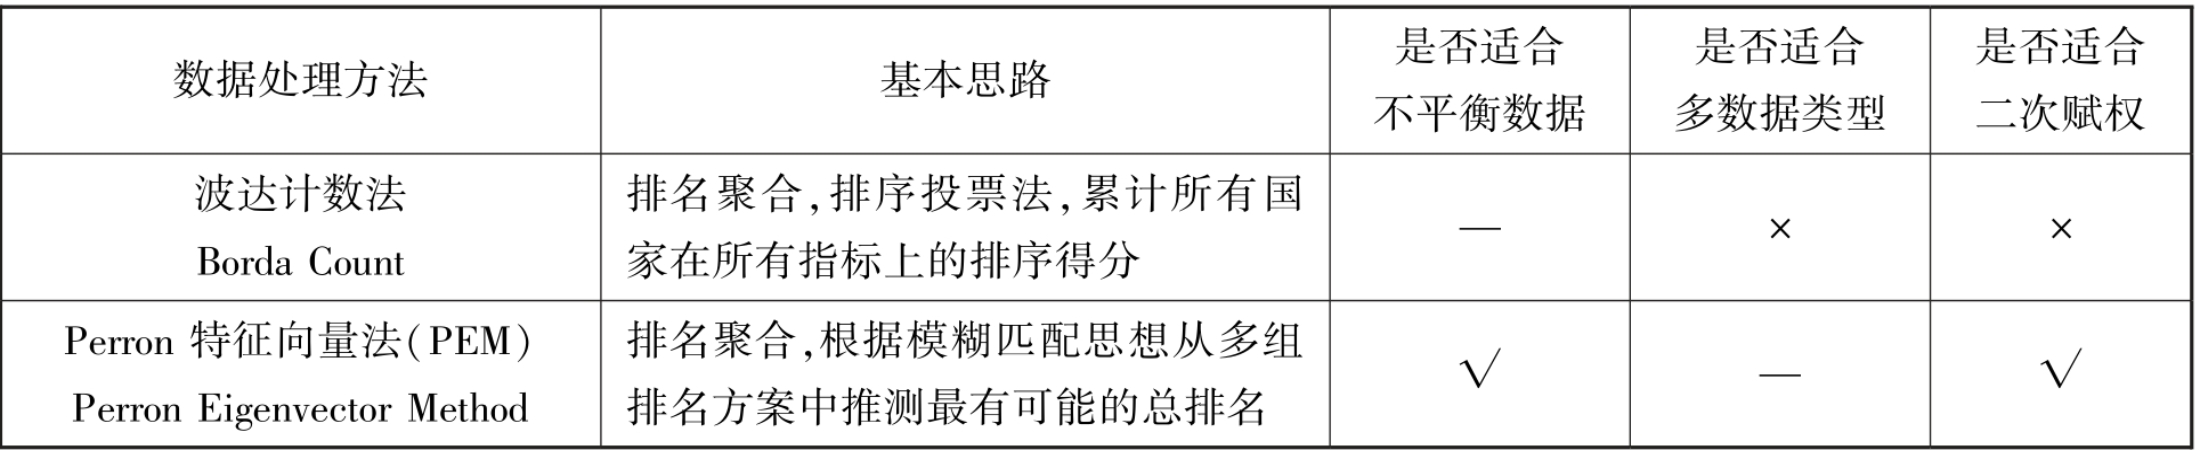
续表4
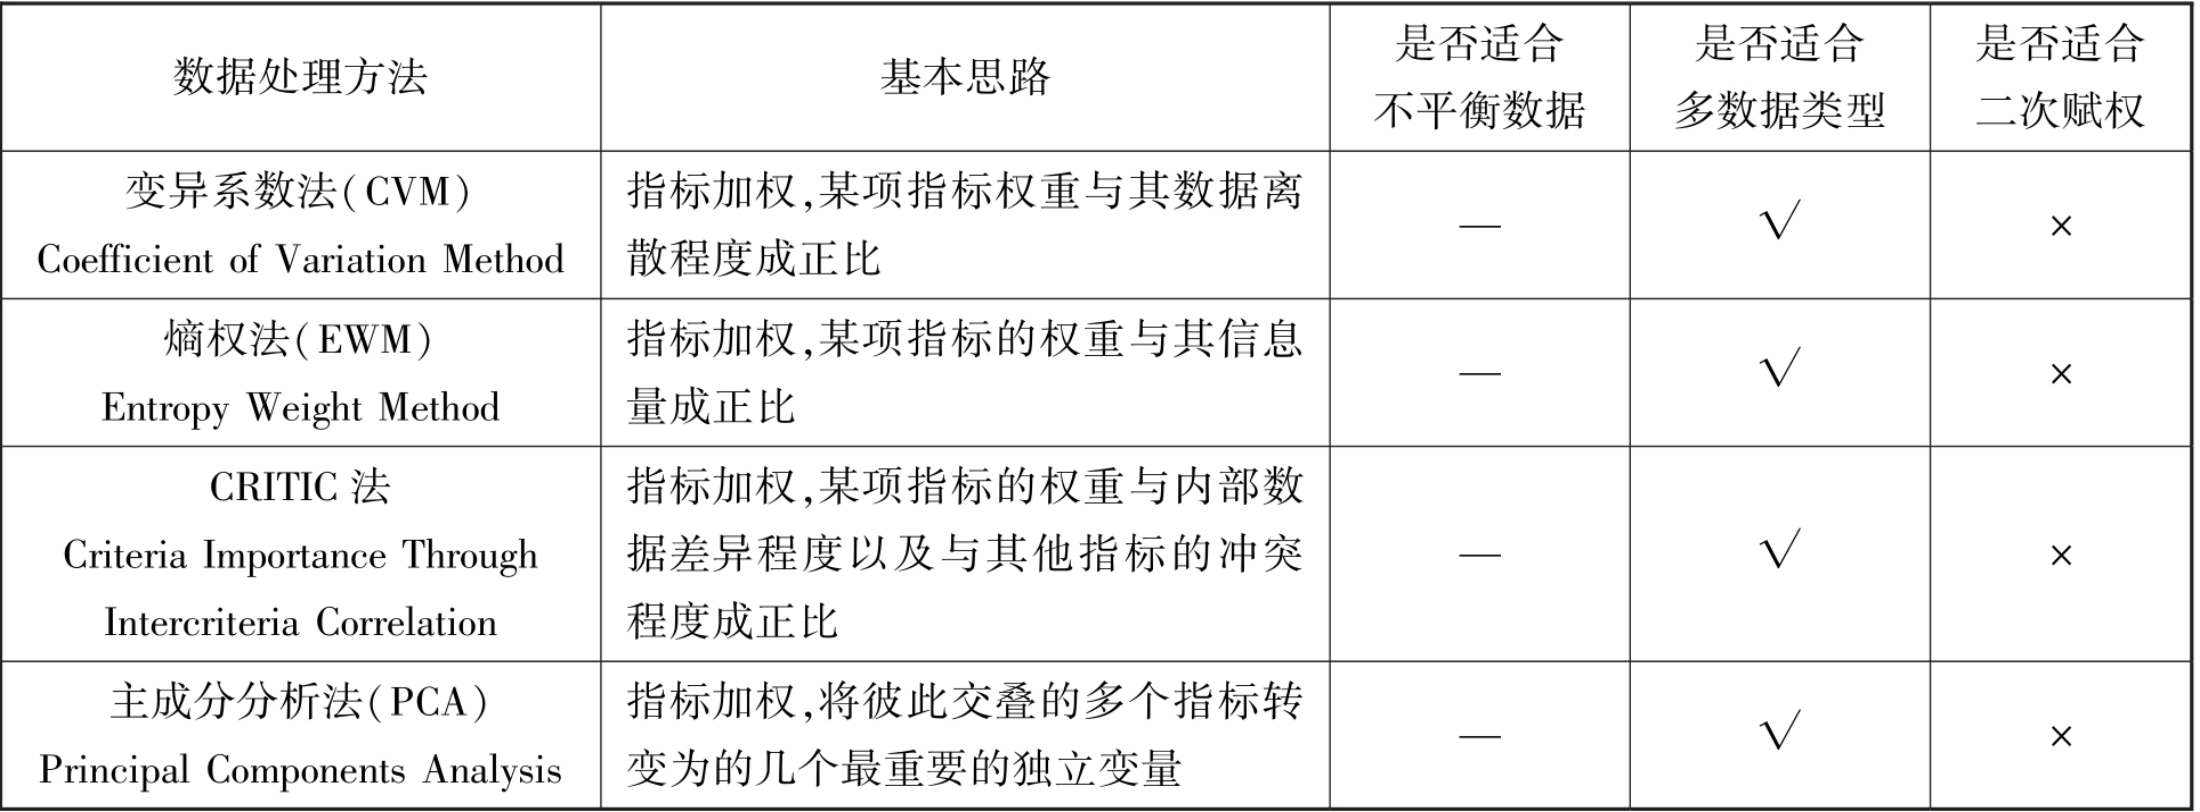
基于表4 中对排名算法的综合评估,我们创造性选择变异系数法(CVM)、熵权法(EWM)、CRITIC法、主成分分析法(PCA)四种指标加权法分别结合PEM 排名聚合法获得三级指标权重,得到全球中文教育发展指数排名的四个候选榜单。
以上四种不同的算法组合,所得到的排名结果有同有异。 我们通过以下三步优选并验证出CVM+PEM 算法为最具代表性和公信力的排名结果:
首先,排除PCA+PEM 算法结果。 从表5 可以直观看出,后三种算法中前20 名的国家范围基本一致,且排名差异不大。 而在PCA+PEM 算法中,巴基斯坦、马达加斯加和乌克兰取代日本、葡萄牙和蒙古,跃居前20,德国、法国等的排名与其他三种算法结果也差距很大。
表5 全球中文教育发展总排名(前20 名)
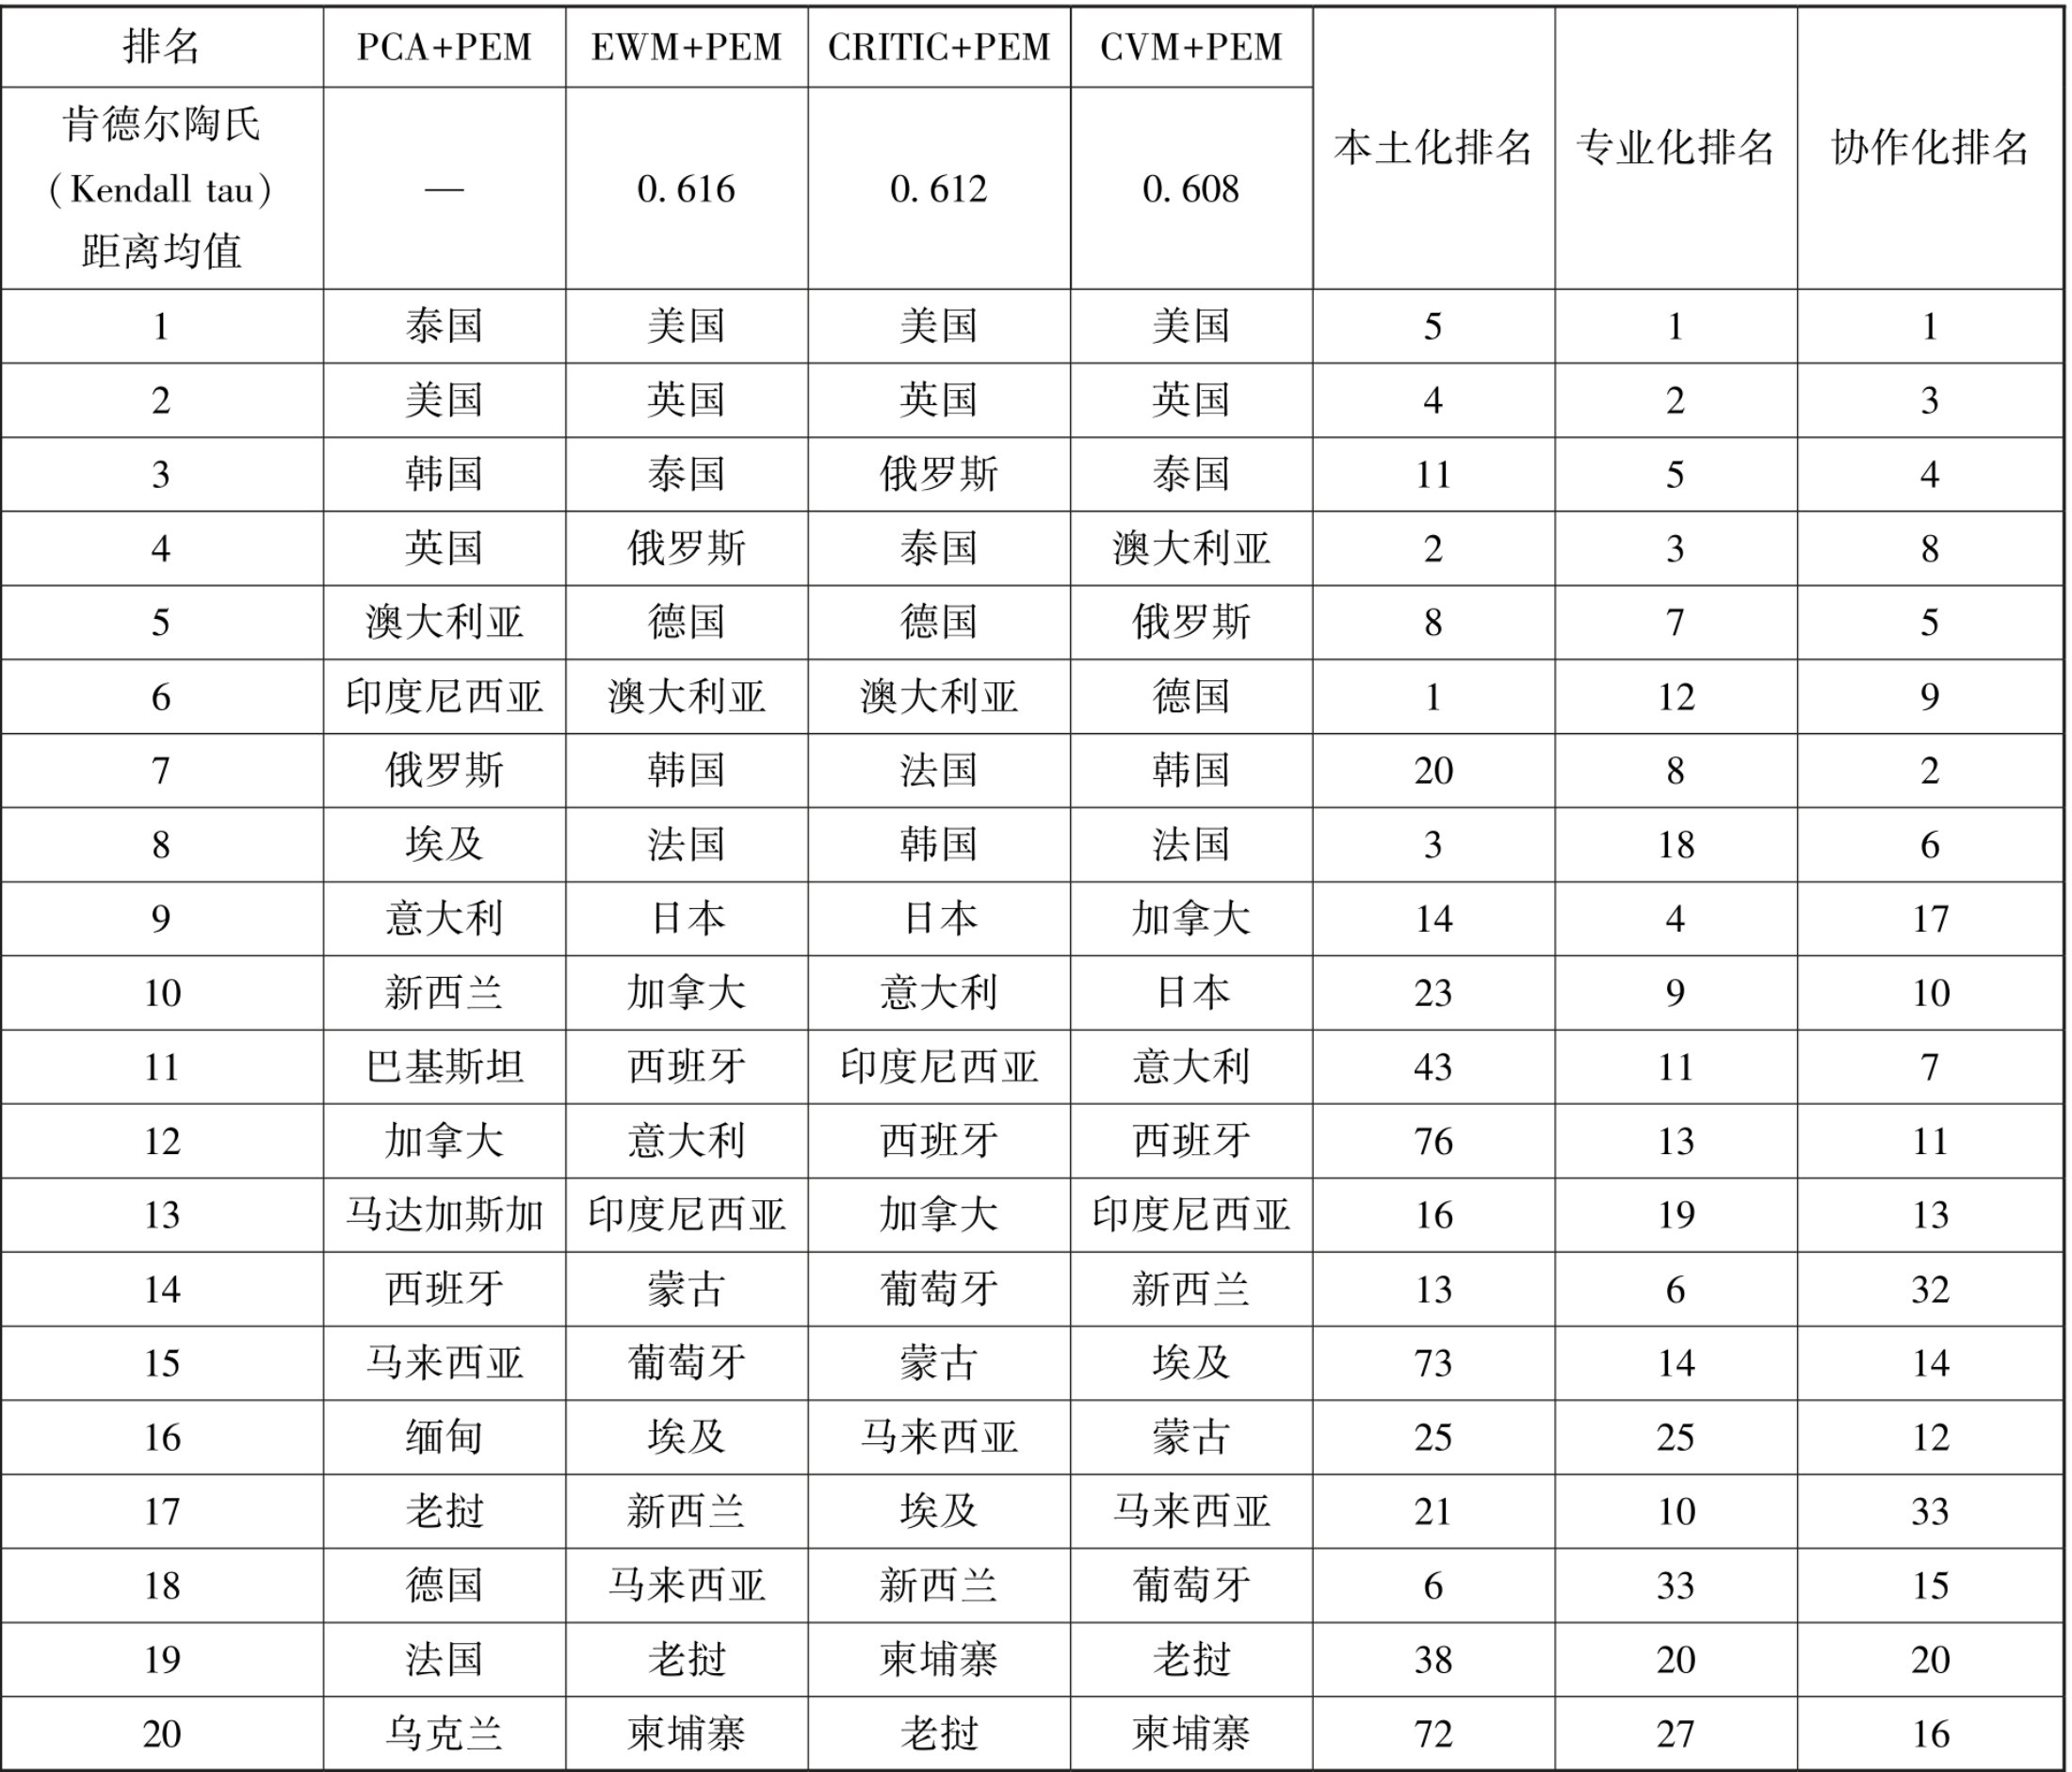
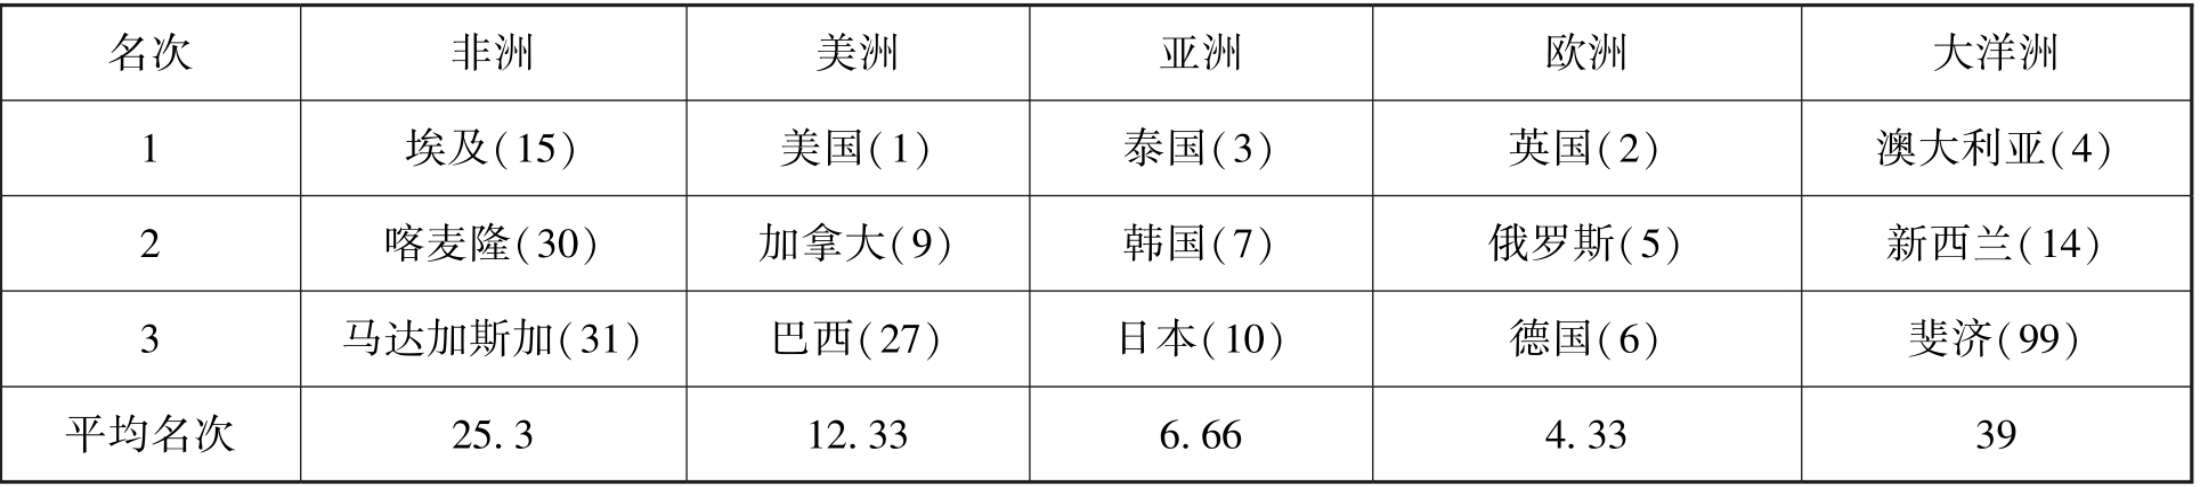
表6 各大洲中文教育发展指数前3 名(及其全球排名)
其次,分别计算剩余三种排名结果两两之间的肯德尔陶氏距离①肯德尔陶氏距离(Kendall Tau Distance)是计算两组排名之间距离的一种方法,其值越小表示相似度越高,计算公式为:K(r1,r2)= ∑Ki,j(σ1, σ2),式中Ki,j(σ1, σ2)的值在当比较项i 与比较项j 排名一致时为0,而当i 与j 排名不一致的时候值为1。。 如果该排名与另外两种排名之间的距离最近,说明该方法与另外两种方法的排名差异最小,最具代表性。 结果发现,CVM+PEM 算法得到的距离均值最小,为0.608(见表5)。
最后,我们请前述33 位专家对表5 中排名前20 的国家的中文教育实力进行背对背评价。 然后,运用肯德尔秩相关系数分析了33 位专家内部意见的相关性,以及33 位专家给出的排名与全球中文教育指数排名(基于CVM+PEM 排名)之间的相关性。 数据分析结果显示,33 份专家排名数据彼此之间全部呈正相关关系,即专家意见基本一致。 专家主观排名的综合结果与CVM+PEM 数据驱动排名的一致性达84.8%。
综上,CVM+PEM 算法最终被确定为三级指标赋权的最佳算法,后文的分析讨论均以该算法的排名结果为依据。
分析排名结果发现,同一个国家本土化、专业化、协作化三个指标上的发展似乎并不平衡。 这种不平衡是否普遍? 哪些国家的某个指标相较于另两个指标更弱或更强? 为了继续探究这一现象并回答这些问题,我们采用K-Means 算法②K-Means 算法又叫K 均值聚类算法(K-Means Clustering Algorithm,简称K-Means)。 它是一种迭代求解的聚类分析算法。 该算法原理为:先将数据分为K 组,随机选取K 个对象作为初始的聚类中心,然后计算每个对象与各个种子聚类中心之间的距离,将每一个对象分配给距离它最近的聚类中心, 聚类中心以及分配给它们的对象就代表一个聚类。该算法将输入表的某些列作为特征,根据用户指定的相似度计算方式,将原始数据聚成若干类。,把153 个国家的三个一级指标排名作为三个聚类变量,将每个国家的中文教育类型化,并用雷达图③雷达图由一系列等角辐条组成,在该案例中,每个辐条代表一个指标的排名。 离中心点越远,排名越靠前。 每个辐条的数据值之间画有连接线,代表每个指标的排名。显示聚类结果(见图1)。 三角形面积越大,排名越靠前。 三角形的某一顶点离圆周越近,则对应的一级指标实力越强,反之越弱。 比如,本土化相对于其他两个指标强过了一定程度,则认定其为强本土化型。 反之亦然。
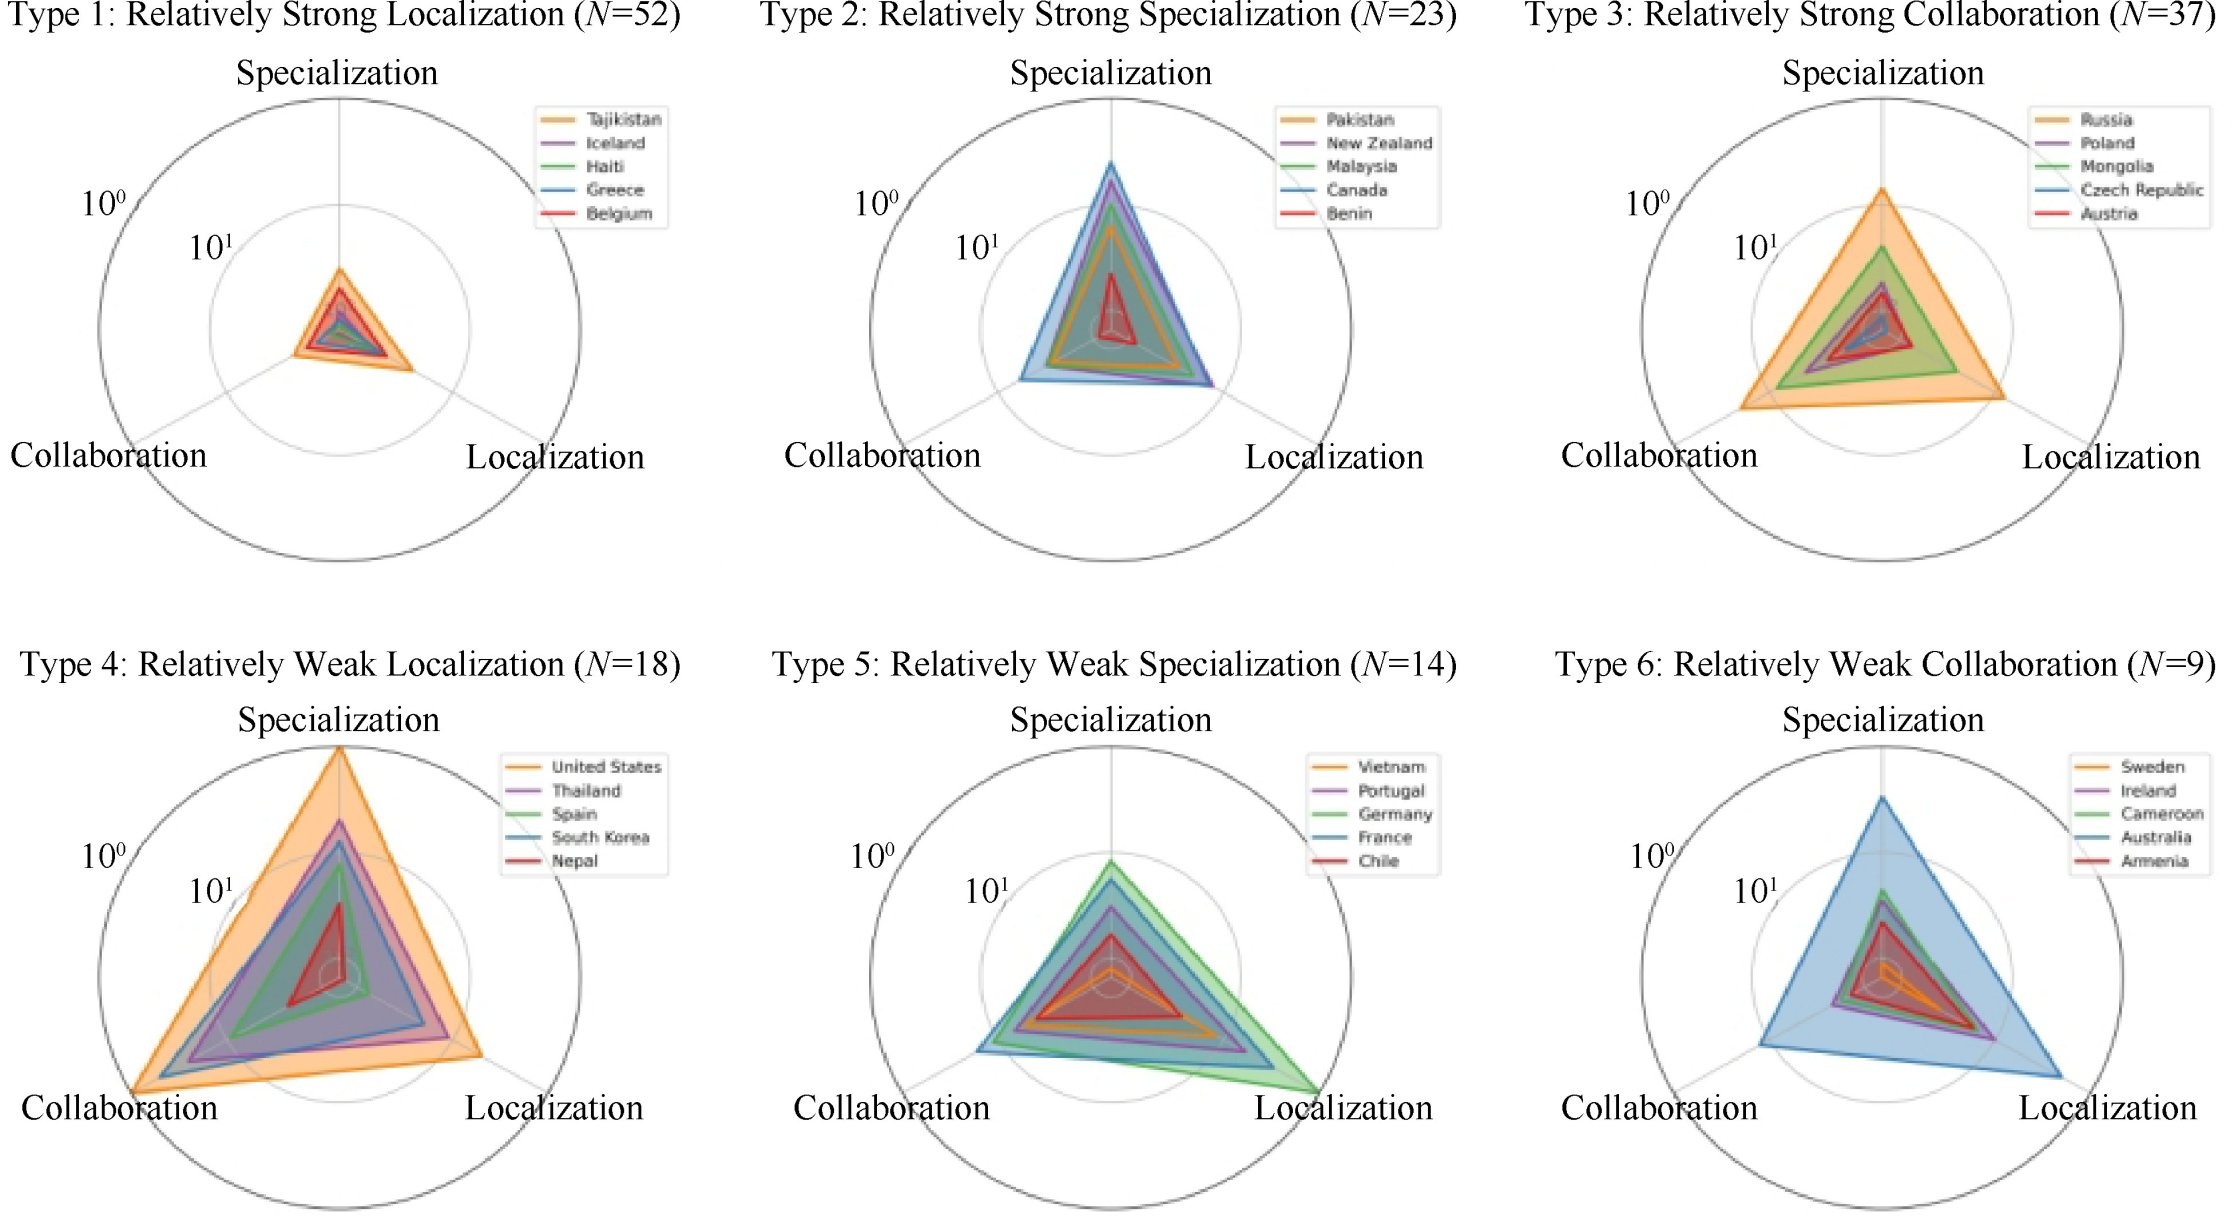
图1 全球中文教育的六大类型
K-Means 聚类结果显示,全球中文教育共有六个类型的国家:
(1)强本土型,即相对于其他一级指标,本土化方面较为突出。 这一类型的国家最多,共52 个,包括塔吉克斯坦、冰岛、海地、希腊、比利时等,但总体排名相对靠后。
(2)强专业型,即相对于其他一级指标,专业化方面较为突出。 这一类型的国家有23 个,如巴基斯坦、新西兰、马来西亚、加拿大、贝宁等。
(3)强协作型,即相对于其他一级指标,协作化方面较为突出。 这一类型的国家有37 个,包括俄罗斯、波兰、蒙古、捷克、奥地利等。
(4)弱本土型,即相对于其他一级指标,本土化方面较弱。 这一类型的国家有18 个,包括美国、泰国、西班牙、韩国、尼泊尔等。
(5)弱专业型,即相对于其他一级指标,专业化方面较弱。 这一类型的国家有14 个,包括越南、葡萄牙、德国、法国、智利等。
(6)弱协作型。 即相对于其他一级指标,协作化方面较弱。 弱协作化型国家最少,只有瑞典、爱尔兰、喀麦隆、澳大利亚和亚美尼亚等9 个国家。 该类型的国家数量最少,原因可能是中国作为中文母语国为各国中文教育的早期发展提供了大力支持。 而瑞典是一个典型特例,其协作化程度接近于零。
各国中文教育处于动态发展中,其类型也会不断变化。 所属类型的动态变化直观地反映出该国中文教育的发展态势,为本土与中文母语国提供了及时、有效的决策依据。
指数排名结果也呈现出显著的区域分布特征。 从各大洲排名前三的国家来看,欧亚地区拥有诸多中文教育实力较强的国家,且这些国家的实力较为均衡。 美洲,尤其是北美洲,整体实力十分雄厚。 非洲国家中文教育总体实力还有待提升,但非洲位于前3 的国家实力较为均衡。 澳大利亚是大洋洲地区中文教育发展最好的国家,新西兰次之。
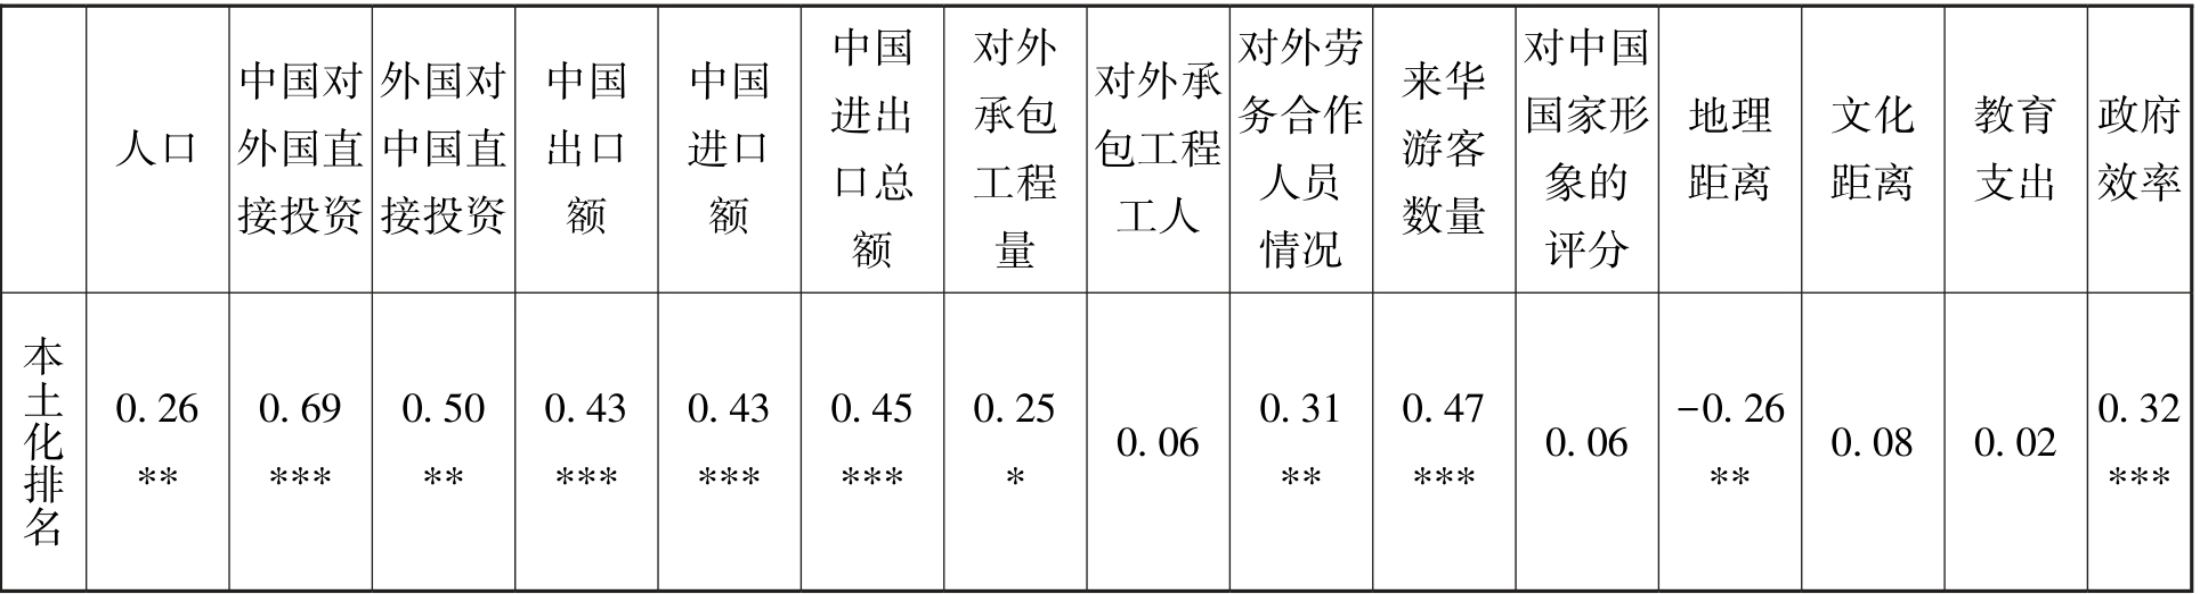
为了进一步探究全球中文教育的分布特征与外部因素的关系,我们引入了15 种外部数据集(见表7),并运用斯皮尔曼相关系数①斯皮尔曼等级相关系数(简称等级相关系数,或称秩相关系数,Spearman’s rank correlation coefficient 或Spearman’s ρ)是衡量两个变量的相关性指标。 它利用单调函数评价两个统计变量的相关性。 若数据中没有重复值,且当两变量完全单调相关时,斯皮尔曼相关系数为+1 或-1。对三个一级指标排名和外部因素进行相关性分析,最终得到显著性水平矩阵(见表8)②其中数值为相关系数,正数为正相关,负数为负相关,其绝对值越大,则线性相关性越强。 星标个数代表不同级别的显著性水平,即其对应数值的置信度。 根据假设检验常用的p<0.05 即为显著的准则,在表格中只要有星标的相关系数即可认为显著相关,星标数量越多,则置信水平越高。 无星标则为非显著相关。。
表7 相关因素分析的外部数据集
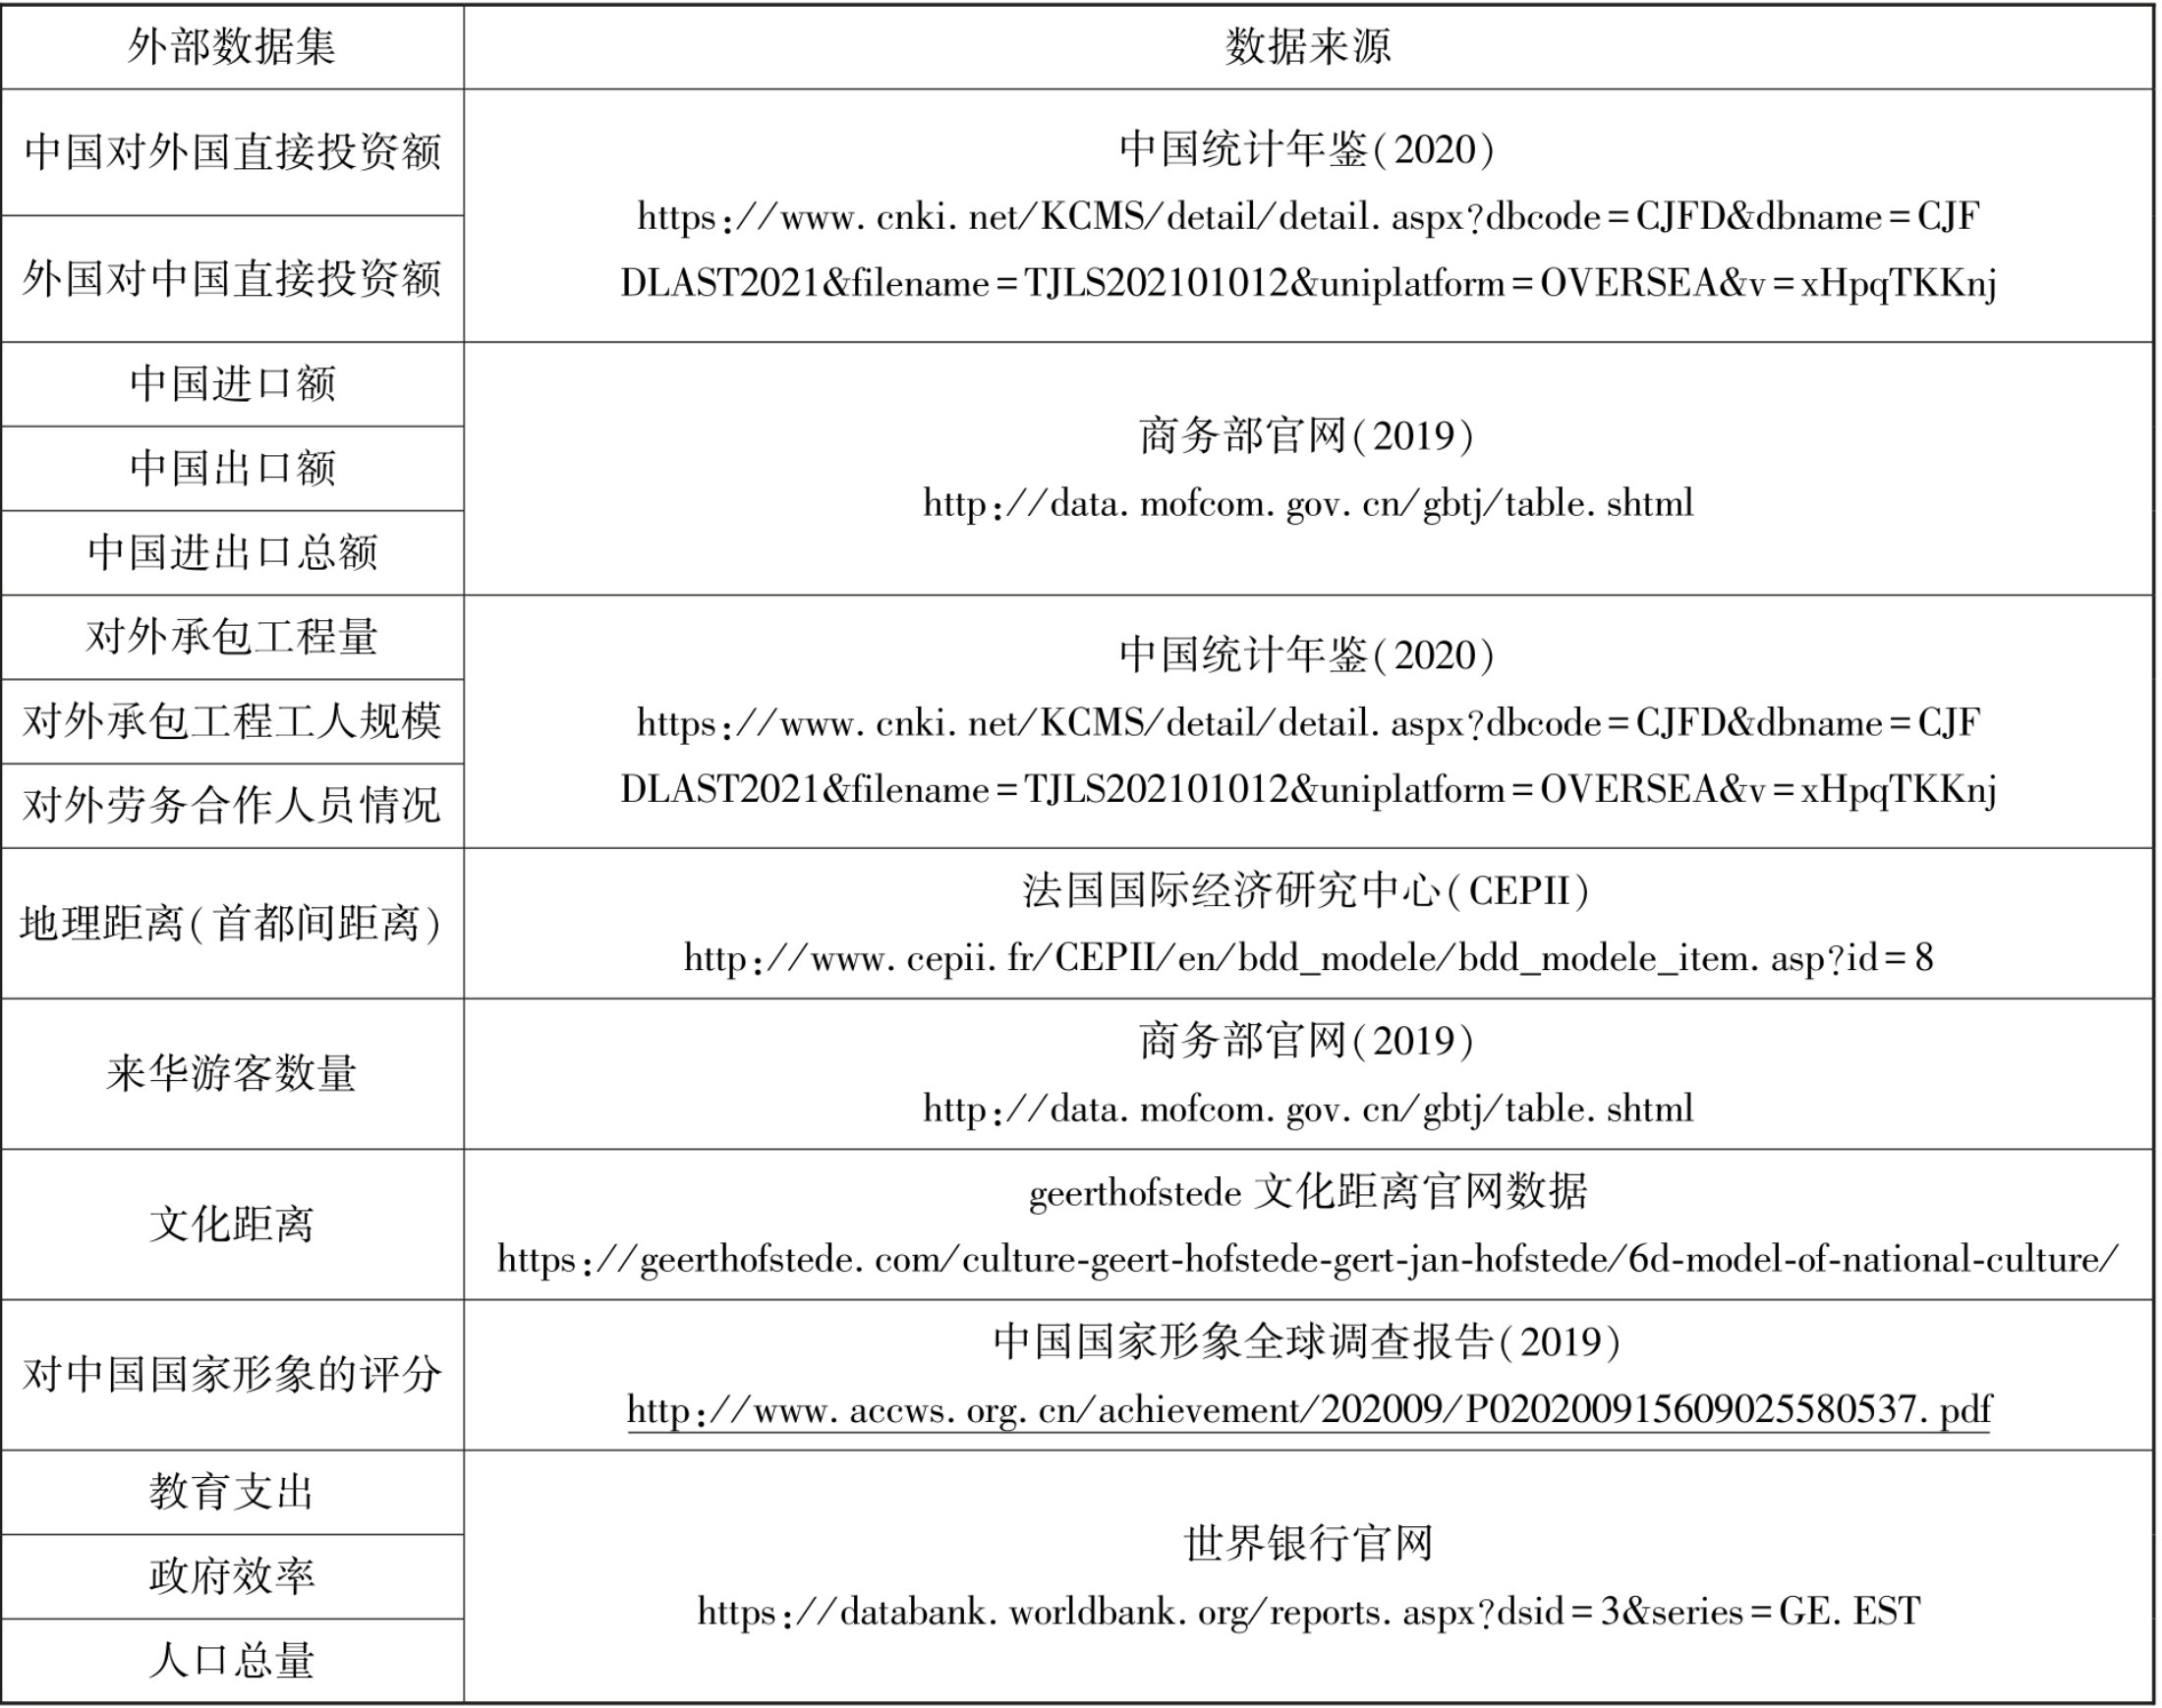
表8 三个一级指标与外部因素的相关性
续表8
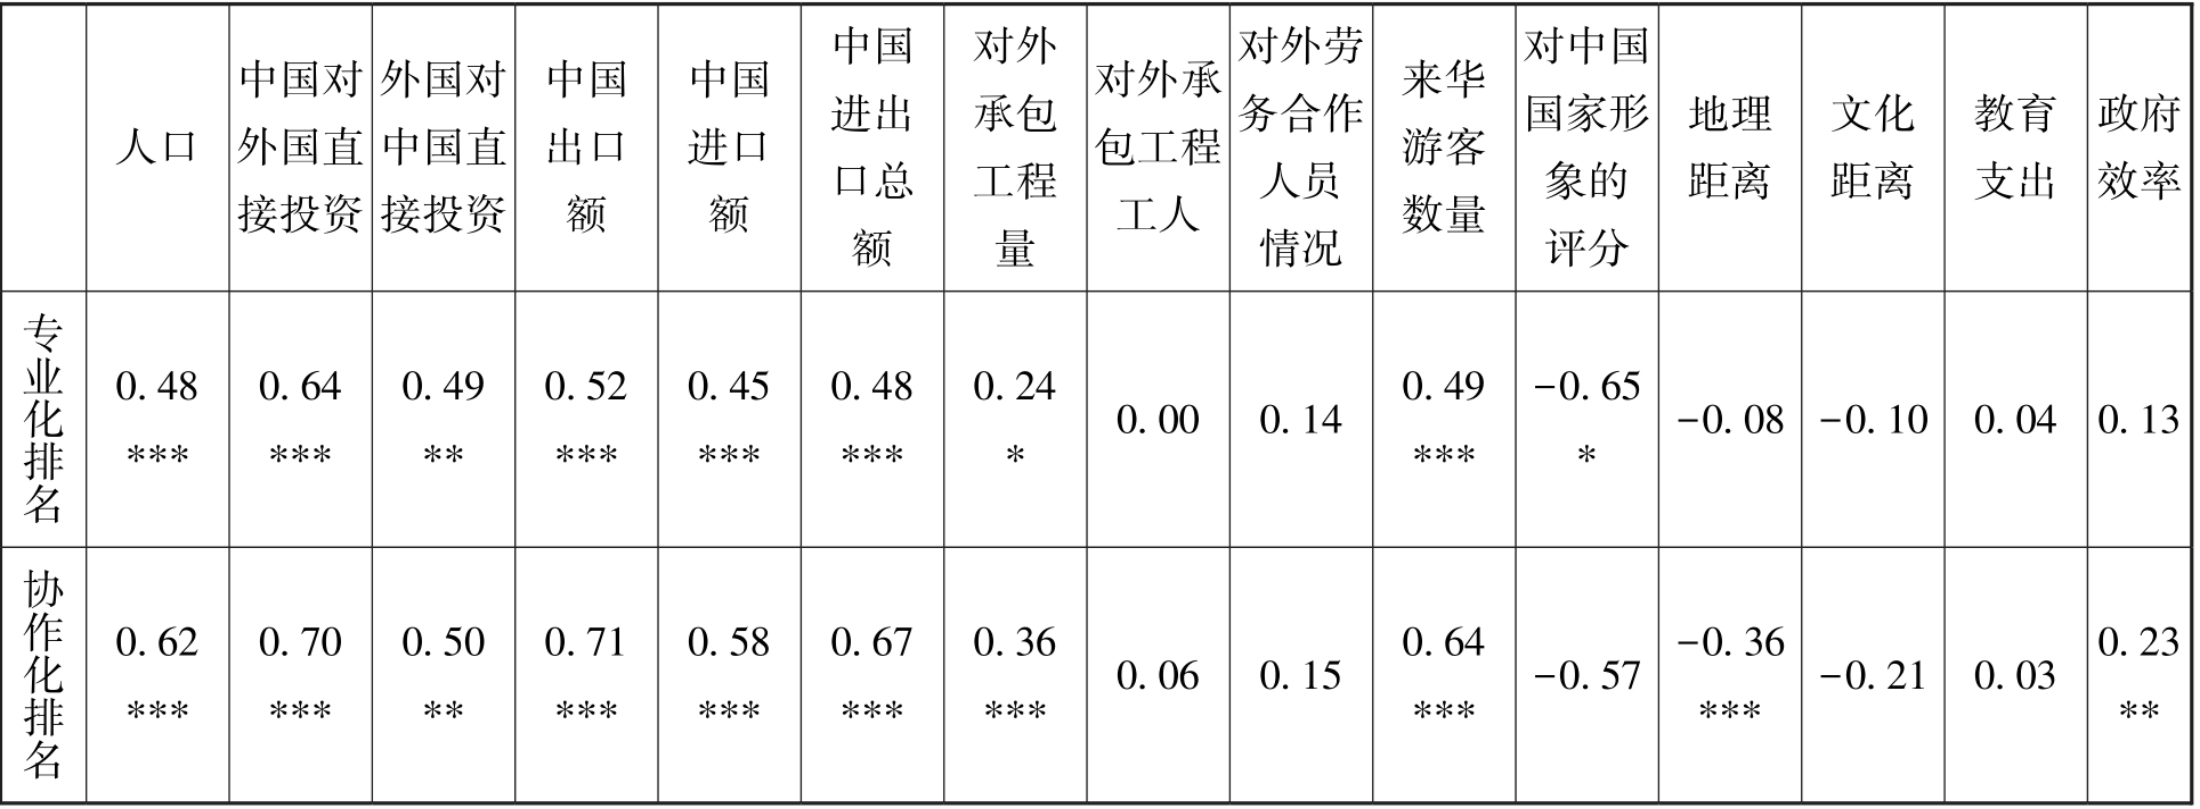
注:***:p<0.001;**:p<0.01;*:p<0.05;剩余:p≥0.05
相关性分析结果表明,人口、中外直接投资、中国进出口额、对外承包工程量和来华游客数量等与中文教育本土化、专业化、协作化发展都有非常显著的正相关关系。 一般而言,人口基数越大,其中文教育发展的规模可能性越大。 而其他经济因素与全球中文教育发展的高度相关性恰恰说明了经贸往来与语言文化交流是双向作用的①李宇明、唐培兰:《国际语言传播机构发展历史与趋势》,《世界汉语教学》2022 年第1 期。。
值得注意的是,中国形象评分与专业化显著负相关。 其中,美国、韩国、澳大利亚、英国等一些专业化排名越高的国家,对中国国家形象的评价越倾向于负面。 此外,政府效率与本土化和协作化显著相关,而与专业化关系不显著。 而文化距离和教育支出对三个指标都没有显著影响。 地理距离与三个指标均负相关,尤其是与本土化指标显著负相关,即中国与对象国的地理距离越近,两国之间的中文教育合作越密切,该国的本土化发展水平越高。
未来我们还需要进一步了解对象国的支持力度、民众的学习需求以及政治关系②尹春梅:《汉语国际传播影响要素研究范式探讨》,《东北师大学报(哲学社会科学版)》2021 年第3 期。等影响程度。 其中政治关系是至关重要的影响因素③李宇明、唐培兰:《国际语言传播机构发展历史与趋势》,《世界汉语教学》2022 年第1 期。,然而由于世界局势多变,且难以通过整齐的数据集量化,本文暂未将其纳入。
(感谢教育部语合中心、国际中文教育基金会、全球汉语国际传播动态数据库、北京外国语大学中文学院的数据支持;感谢崔希亮、赵杨、吴应辉、宋继华、李宝贵、郑艳群、陈默、王春辉、戴曼纯、熊文新、吴思娜、王祖嫘等专家对本文的宝贵意见和建议;感谢德国哥廷根大学傅晓明教授、李政泽博士的技术帮助;感谢北京外国语大学中文学院2025 届硕士研究生王雪对本文做出的重要贡献! 文中不足之处一律由作者承担。)
作者简介: 陈慧,北京外国语大学中文学院副教授。
基金项目: 本文系教育部语合中心2022 年度国际中文教育基地项目“国际中文教育发展指数研究与设计”(22YHJD1047)、北京外国语大学双一流建设重大标志性项目“国际中文教育发展及中文传播力研究”(2022SYLZD043)、“全球指数系列研究(2023)”(2023SYLZD011)、北京外国语大学中央高校基本科研业务费项目“基于大数据的中文国际传播力及受众情感分析”(2023JJ022)的阶段性成果。
(责任编辑:子聿)

