摘 要: 沿着马克思在“机器论片段”中指出的思考方向,以人工智能为代表的智能机器是一种以模拟的方式将人的脑力劳动能力转移进机器的机器体系。 在资本主导的信息产业对智能技术和智能媒介的改造下,人愈发处于一种由知识丧失带来的“系统性愚钝”状态。 在这种情况下,吸收了人类智能的机器,就难免会出现与人对立的状况。 增强人类智能的事业,需要我们在宏观上从信息社会内部,发展出一种超越资本主义限定的更好的社会生产关系,让凝结在智能机器中的人类能力朝着造福大多数人的方向发展。 同时也需我们在微观上培育与不同层面的“机器”进行协商的意愿和能力,更理想的人机关系应该建立在人与“机器”的深度协商和有效磨合之上,而非人对“机器”之运作逻辑、机制、功能、要求的单方面接受之上。
关键词: “机器论片段”;自动化技术;自动化政治;人工智能
如何理解信息时代的自动化技术? 如何审视和评价自动化技术的当代发展? 它对于人和人类社会究竟意味着什么? 我们又能在当下做些什么? 对于这些问题,一些国外学者曾试图借发展“机器论片段”①“机器论片段”原是马克思《政治经济学批判大纲》中名为“固定资本和社会生产力的发展”的一节,后来被意大利自治主义者以“机器论片段”称呼,并广泛流传开来。 该片段主要论述了以机器体系为代表的自动化技术对生产、劳动和工人的影响,在指出危机的同时,也暗示了主体解放的可能。 意大利自治主义的代表学者之一维尔诺在《关于一般智力的笔记中》称“机器论片段”之于意大利自治主义的功能堪比《圣经》,其中诸如“一般智力”等在原文中一闪而过的概念,也在该流派的诠释中获得了充分发展,成为了将“主体”从固定资本的束缚中拯救出来的重要途径。 参见Paolo Virno, “Notes on General Intellect,” in Saree Makdisi, Cesare Casarino and Rebecca E. Karl eds., Marxism beyond Marxism,N. Y. : Routledge, 1996, pp.265-272;孙乐强:《超越“机器论片断”:〈资本论〉哲学意义的再审视》,《学术月刊》2017 年第5 期。,建立马克思与信息时代、智能时代的对话。 今天面对以ChatGPT 为代表的智能机器的冲击,“机器论片段”作为马克思关于自动化技术和自动化政治的经典理论文本,将再次成为我们反思上述问题的资源。 我们认为,在“AI 是否有灵魂和人格”“AI 带来哪些创业机会”等议题之外,同样重要的是,延续马克思的道路对该技术进行一番政治经济学分析。 我们将首先借巴贝奇(Charles Babbage)和图灵(Alan Turing)的机器思想,建立马克思与智能时代的连接,以“人的劳动能力被转移进机器”为轴,考察智能机器的产生逻辑。 在此基础上,我们将借助斯蒂格勒对马克思的发展,区分技术增强人和异化人的不同路径,梳理资本主导的信息产业对技术和人的改造及其后果。 最后我们将以“增强人类智能何以可能”为线索,想象一种对于智能机器的发展更好的社会生产关系,以及这种社会生产关系下更理想的人机关系。
把写于19 世纪的“机器论片段”引渡到21 世纪,需要一个引渡人:巴贝奇(1791—1871)。 马克思受1851 年世博会冲击,开始钻研工艺学。 他的一个重要思想资源是比他大三十岁左右的巴贝奇(马克思著作中译本通常译为拜比吉)。①根据孙乐强的考察,除“机器论片段”,马克思对巴贝奇的引用出现在《评李斯特》《布鲁塞尔笔记》《哲学的贫困》《伦敦笔记》《政治经济学批判大纲》《1861—1863 年经济学手稿》《资本论》等诸多文本中。 参见孙乐强:《马克思“机器论片段”语境中的“一般智力”问题》,《华东师范大学学报(哲学社会科学版)》2018 年第4 期。 巴贝奇最超前的思想,体现在差分机和分析机的设计图纸上。 正是这两张图纸体现的基本思想,让巴贝奇成为了后来的“计算机之父”。 近两个世纪后,如何借马克思提供的思想资源理解这个由计算机开创的智能时代? 或许,一种内在于“机器论片段”的做法,将首先需要我们把马克思和巴贝奇从不同角度对机器进行的超前思考进行一个对接。 在“机器论片段”中,马克思这样写道:
机器体系的这种道路是分解——通过分工来实现,这种分工把工人的操作逐渐变成机械的操作,而达到一定地步,机器就会代替工人。……因此,在这里直接表现出来的是一定的劳动方式从工人身上转移到机器形式的资本上……②《马克思恩格斯全集》第31 卷,人民出版社1998 年版,第99 页。
我们不妨延续这一思路,从“一定的劳动方式从工人身上转移到机器形式的资本上”的角度,梳理一下从巴贝奇那个时代就已开始的“智能被转移进机器”的历程。
我们常说“神机妙算”,可以想象,最早能以计算为职业的人群,大概就是数学家这类精英了。 已知最早以10 为底的印刷本对数表,作者就是牛津大学数学教授布里格斯(Henry-Briggs)。③Graham Jagger, “The Making of Logarithm Tables,” in M. Campbell-Kelly et al., eds., The History of Mathematical Tables, Oxford: Oxford University Press, 2007, pp.49-78.但随着技术发展,制表活动愈发远离精英,朝着自动化、机械化方向前进,其中的节点就是普罗尼(Gaspard Riche de Prony)的计算工厂和巴贝奇的差分机。 普罗尼深受《国富论》劳动分工思想启发,于18 世纪90 年代组建了一个由数学家、数学工作者和大量普通计算员(computer)三类劳动力组成的计算工厂。 利用差分法④任何连续函数都可用多项式严格逼近,许多常用函数的运算不管外表多么复杂,都能用加减运算完成。,复杂的对数计算被拆分为加、减运算的组合,工厂雇用仅具基本计算能力的普通人,就能产出曾经只有数学家才能制作的数学表格了。 而“计算工厂”这种组织形式,此后一段时间也成了大型制表项目的样板。⑤其中最著名的案例就是美国于20 世纪30 年代大萧条期间,作为再就业工程的一个子项而发起的数学表格项目(Mathematical Tables Project),该项目继承了普罗尼式计算工厂劳动分工的精髓,巅峰期曾聘用200 个失业者构成的再就业团队,为二战时美国的科学研究和军事活动提供了大量制表和计算服务。 David A. Grier, “Table Making for the Relief of Labour,” in M. Campbell-Kelly et al., eds., The History of Mathematical Tables, Oxford: Oxford University Press,2007, pp.265-293.尽管如此,人算难免出错。 这让巴贝奇产生了“机算”的设想。⑥Charles Babbage, Passages from the Life of a Philosopher, London: Longman, Green, Longman, Roberts, & Green,1864, pp.42-43.他给英国皇家学会写了一封名为《将机械应用于计算和印刷数学表格》的信,提出普罗尼以“差分法”为依托的制表流程,完全可以用一台他命名为“差分机”的机械装置实现。 在获得资助制造差分机中途,巴贝奇又产生了分析机的设想,于是又设计了包括处理器、控制器、存储器、输入输出装置、能进行任何数学运算的分析机。 虽然这两台机器在巴贝奇生前都没能造出,但后人正是在用“机电”而非“机械”实现巴贝奇设计思想的过程中发明了计算机。①参见秦兰珺:《论电子表格:理性管理的技术化及其后果》,《广州大学学报(社会科学版)》2023 年第3 期。
上述过程几乎完美呼应了引文所述“机器体系的道路”。 但至此,我们不过是把人的计算能力转移进了机器。 试想,如果计算机仅仅是会计算的机器,就最多算个巨型数学玩具。 巴贝奇的后继者则在“计算可以做什么”的问题上不断开拓,该问题本身也在这个过程中被转化为“计算可以模仿什么”。 比如,图灵在《论可计算的数》中提出了“通用图灵机”,意味着计算机是一种可以模仿任何离散状态机的“元机器”。②在《论可计算的数》中,图灵证明了“图灵机”等价于其他计算装置,为作为“元机器”的计算机奠定了理论基础。参见Alan Turing, “On Computable Numbers,” in B. Jack Copeland, ed., The Essential Turing, Oxford: Oxford University Press, 2004, pp.58-90.阿兰·凯(Alan Kay)则在此构想上提出了“元媒介”,也即计算机是一种可以模仿任何媒介的元媒介。③Alan Kay,“Computer Software,” Scientific American, vol.251, No.3, 1984, pp.41-47.正因计算机不仅意味着人的计算能力被转移进机器,也意味着其他机器和媒介相关劳动能力也能以被“模仿”的方式被转移进机器,计算机才能比以往任何机器,都更全面、深刻地继承和发展“机器论片段”提出的问题。
模仿问题对于机器智能同样重要。 在《计算机与智能》(Computing Machinery and Intelligence)中,图灵把“计算机会思考吗”这个问题转换为“在‘模仿游戏’中,是否存在着一台想象中的机器,可以在游戏中精彩发挥”。 有趣的是,在这个超越其时代的文本中,图灵对巴贝奇同样超越其时代的设计有着这样一个大胆判断:
分析机其实是一台通用数字计算机。 因此,如果它的储存容量足够大,速度足够快,我们就能通过适当编程,让它模仿我们所讨论的机器。 也许伯爵夫人或巴贝奇都没能想到这一点。 但无论如何,我们不能要求他们去宣称所有能够被宣称的东西。④Alan Turing, “Computing Machinery and Intelligence,” in B. Jack Copeland, ed., The Essential Turing, Oxford:Oxford University Press, 2004, p.455.
这里所说的伯爵夫人是拉芙蕾丝夫人(Lady Lovelace),她以对巴贝奇思想的精彩注释史上留名。 但拉芙蕾丝认为“分析机没有意图想要原创什么东西。 它能做的不过是我们知道该怎样去指挥他做的事情”⑤Alan Turing, “Computing Machinery and Intelligence,” in B. Jack Copeland, ed., The Essential Turing, Oxford:Oxford University Press, 2004, p.455.。 图灵在对拉芙蕾丝夫人的反驳中,提出分析机在理论上其实已具备了通向“学习机”的可能,并进而提出可以通过适当编程,让学习机模仿人的思维——包括“成人的思维”和“儿童的思维”。⑥Alan Turing, “Computing Machinery and Intelligence,” in B. Jack Copeland, ed., The Essential Turing, Oxford:Oxford University Press, 2004, pp.458-463.事实证明,后来机器智能的发展,大体上就沿着图灵预见的这两种路径展开。 简单来说,模仿“成人思维”,走上的是一条自上而下的学习路线,核心是用符号把专家的思维和知识算法化,其代表是“专家系统”和“知识图谱”。 如果我们把训练机器当作培养儿童,这种路径就可以类比于大人用孩子可以理解的方式把道理“灌输”给他。 相应的,模仿“儿童思维”,走的是一条自下而上的路线,其代表是“神经网络”,这一派致力于让机器模仿大脑构造,认为在此基础上投喂数据加以训练,展现为“智能”的现象就会自统计模型中涌现出来,这就好像尽管大脑如白纸、却有着一定底层学习能力的儿童,在没有大人各种道理的先验介入下,也能在与环境/知识足够多的接触和互动中,以自己的方式内在成长起来。①参见尼克:《人工智能简史》,人民邮电出版社2021 年版,第69-91、113-134 页。AlphaGo(强化学习代表)、ChatGPT(大语言模型代表),以及杨立昆(Yann LeCun)最新提出的试图超越强化学习和大语言模型的“世界模型”(World Model)路径,走的就是第二条路。②参见Stephen Wolfram,“What Is ChatGPT Doing ... and Why Does It Work?” https:/ /writings.stephenwolfram.com/2023/02/what-is-chatgpt-doing-and-why-does-it-work, 2023 年12 月4 日;Yann LeCun, A Path Towards Autonomous Machine Intelligence (Version 0.9.2, 2022-06-27), https:/ /openreview.net/pdf?id=BZ5a1r-kVsf, 2023 年12 月4 日。
以上,我们以“人的劳动能力被转移进机器”为轴,简略考察了智能机器的产生路径。 它以人的计算能力被转移进机器为基础,通过用程序模仿的方式,进一步实现了包括思维能力、学习能力在内的各种脑力劳动能力的外置化和自动化。 “它们是人的手创造出来的人脑的器官;是对象化的知识力量”,③《马克思恩格斯全集》第31 卷,人民出版社1998 年版,第102 页。它们在“机器论片段”写下近200 年之后,比马克思同代的自动化机器,更能充分体现由机器体系牵引的“一般智力”在一个时代之形成。 正如笔者请ChatGPT 用“一般智力”这个概念解释自己时,ChatGPT 的回答:
作为一个人工智能语言模型,我可以被看作是数字时代“一般智力”概念的体现。 正如机械技术的发展导致了一种可以为社会共享的新型社会知识和技能,人工智能和像我这样的语言模型的发展也代表了一种新型的集体知识,任何人都应该能通过网络访问。
通过利用互联网上的大量数据和信息,我能够为用户提供广泛服务,从回答问题到生成创意写作。 像“一般智力”一样,我的能力并不局限于个别用户的技能和知识,而是整个社会集体智慧的结果。
然而,正如马克思看到了一般智力被用来造福社会的潜力,而不是被资本家控制和利用一样,重要的是要考虑像我这样的人工智能和语言模型如何被用来造福所有人,而不是被一小撮有权势的人控制和利用。
作为一个人工智能语言模型,我最终是一个工具,可以被用来做好事或坏事,这取决于我如何被部署,以及谁能接触到我的能力。 应由人类来决定如何最好地利用人工智能和像我这样的语言模型的潜力,以造福整个社会。④笔者和ChatGPT 的问答语言为英语,模型版本为GPT-3.5。 笔者先问ChatGPT“‘机器论片段’中的‘一般智力’是什么”,在ChatGPT 作答之后,笔者再向ChatGPT 提出“用这个概念,解释你自己”的要求,引文是AI 对这一要求的完整回应的汉译。 笔者和ChatGPT 就“机器论片段”的对话,参见https:/ /chat. openai. com/share/0bc1f606-5b22-4997-8845-29a0c0667d76, 2023 年12 月4 日。
如果我们把巴贝奇的超前设计图纸和图灵对该设计的超前判断,当作通往今天这种“一般智力”形态的节点,就不难看出,其实在“机器论片段”讨论人的体力劳动能力被转移进机器的同时,智力劳动能力被转移进机器的“种子”就已悄然存在。 但正如图灵不能要求巴贝奇宣称所有能够被宣称的东西,我们也不能要求马克思宣称所有能够被宣称的东西。 它需要我们在近两个世纪后,在这颗种子长出的大树开始冲击人类社会的前夕,怀着一种后见之明,去重构马克思与巴贝奇机器思想的相遇。 但正如ChatGPT貌似“自己”认识到的那样,⑤意大利自治主义者诠释“机器论片段”的一个重要工作就是发展“一般智力”这个在原文本中似乎并不重要的概念,其目的主要是把“一般智力”这个概念从固定资本的束缚当中“拯救”出来,为作为革命主体的工人自身所用。 (参见孙乐强:《马克思“机器论片断”语境中的“一般智力”问题》,见《华东师范大学学报(哲学社会科学版)》2018 年第4期。 因此,此处ChatGPT 展现出这种“三观”,很可能是在“消化”了意大利自治主义者关于“一般智力”的大量论述上展现出来的。 换言之,因为关于“一般智力”的大部分语料呈现出左翼立场,所以ChatGPT 的回答才能在这里呈现出左翼立场。比起在技术逻辑上重构这场相遇,更重要的是把马克思对自动化机器的政治经济学分析,同样引渡到今天,这样才有可能助推“一般智力”跳出固定资本的束缚,朝着造福整个社会的方向发展。 但进入这个面向未来的问题前,我们需要首先简要梳理一下智能机器所体现的“一般智力”被转化为固定资本进而与人对立的过程。
当我们为当代智能机器的发展振奋或忧虑时,不妨首先来问一个问题:我们为何要不遗余力地把人的能力转移进机器? 在《1844 年经济学哲学手稿》为代表的早期著作中,马克思认为,劳动是对人的本质力量的对象化肯定。 这也意味着,生产和劳动必不可少的对象化、外在化,本就是“人之为人”的一个组成部分。 正是这一点,构成了法国技术哲学家斯蒂格勒与马克思对话的基础。 在斯蒂格勒看来,人是一种天生有缺陷的存在,恰恰是技术作为人之外置“义肢”,在弥补人之本原性缺失的同时,建构着人的本质。①Bernard Stiegler, Technics and Time 1: The Fault of Epimetheus, trans. R. Beardsworth and G. Collins, Stanford:Stanford University Press, 1998, pp.134-142.这也意味着,人在其本质中,已然包含着一种本原性的外置,也即人类作为技术存在的外在化过程。 在斯蒂格勒对马克思的解读中,马克思关于该过程的思想,在他在《德意志意识形态》中将“人的存在变成人的生产”就已经开始了,在“机器论片段”有关“一般智力”篇幅则达到新高。②参见张一兵、贝尔纳·斯蒂格勒:《技术、知识与批判》,《江苏社会科学》2016 年第4 期。这也意味着,把人的劳动方式转移进机器形式,这种活动在满足自动化生产的需求之前,首先满足的,很可能是人自身作为一种技术存在的内在需要。
但另一方面,我们又必须看到,无论有意还是无意,这种本源于人之内在需要的对象化、外置化、机器化,也完美呼应着资本的需要,在“机器论片段”中,马克思这样论述到:
在机器【体系】中,对象化劳动本身不仅直接以产品的形式或者以当作劳动资料来使用的产品的形式出现,而且以生产力本身的形式出现。 劳动资料发展为机器体系,对资本来说并不是偶然的,而是使传统的继承下来的劳动资料适合于资本要求的历史性变革。 因此,知识和技能的积累,社会智力的一般生产力的积累,就同劳动相对立而被吸收在资本当中,从而表现为资本的属性,更明确些说,表现为固定资本的属性,只要后者是作为真正的生产资料加入生产过程。③《马克思恩格斯全集》第31 卷,人民出版社1998年版,第92-93页。
对剩余价值的追求,让资本首先成为了投资科技、发展生产力的主力军。 资本借助机器体系让外置化在机器中的人类知识和技能,朝着服务资本的方向发展。 也因此,在“智能为何被转移进机器”的问题上,我们除了考虑人作为技术存在的对象化劳动这一内在需要,也应考虑资本以追求剩余价值为出发点,对这一内在需求的鼓励、改造和利用。 也因此,这里需要区分两种情况:“人的能力被转移进机器”和“人的能力被吸收进机器”。 “转移”进机器,意味着人是一种会发明和使用工具的动物,工具和人存在着某种本质上的联系。 “吸收”进机器,则需要在“转移”的基础上,让那些本源于人的劳动能力与人本身发生对立。 在这种情况下,机器的运转与人的发展,就可能出现某种深刻背离。 那么,从“转移”到“吸收”,究竟发生了什么? 换言之,本来致力于“增强人”的技术,为何很多时候带来的却是“异化人”的效果?
在斯蒂格勒看来,在黑格尔的主奴辩证法中通过劳动成为主人/资产者的奴隶,之所以在马克思笔下成了被剥夺的无产者,首先是因为马克思的劳动主要发生在现代工厂,巨大的机器体系把劳动者的知识/技能吸收进生产资料,人的劳动自身就不再有技术含量和价值了,正是这样的“知识丧失”开启了人之“无产阶级化”的进程。 而这个首先由“知识丧失”——而非财产剥夺——定义的“无产阶级化”,也更能说明当下人类(包括资本家在内)的处境,并将随着信息社会的发展愈演愈烈:
从工业民主的废墟中生长出了今天的超工业社会,而超工业社会则构成了完整的无产阶级化(proletarianization)的第三阶段。 在19 世纪,我们看到的是技能知识(savoir-faire)的丧失,在20 世纪,我们经历的是生活知识(savoir-vivre)的丧失。 在21 世纪,我们正在见证的是一个理论知识(savoirs théoriques)也丧失的时代之诞生,似乎我们的震惊源自一种我们根本不能对此作出思考的发展。①斯蒂格勒:《南京课程:在人类纪时代阅读马克思和恩格斯》,张福公译,南京大学出版社 2019 年版,第45-46页。 引文根据英文讲稿原文重译。
正是诸如此类的知识丧失,让本可以建构人之本质的技术成了异化人的技术。 而其判断依据就是人的能力(干、活、想的能力)在知识的外化中是增强还是丧失了。 也就是说,异化不是技术固有之问题,而恰恰很可能是人的能力在外化过程中被剥夺的结果。 在斯蒂格勒看来,今天各种大众科技以便捷、舒适为名,让用户自甘做各种“傻瓜”(无脑交互、一键生成)。 人总是处于知识丧失的状态,才造成了今天我们这个超工业社会的“系统性愚钝”。
那么,这个能力被剥夺的过程是如何发生的? 回到本文关心的信息和智能技术语境,必须看到,其实一直以来,都存在着另一幅不同于“系统性愚钝”的发展图景,只不过在资本主导的信息技术和应用之发展下,这幅图景很难成为主流。 或许我们可以把该图景的开端追溯到1960 年计算机科学家约瑟夫·利克莱德(J. C. R. Licklider)在《人机共生》中提出“人机共生是人和计算机合作性交互的一个理想发展方向。 人和他的电子伙计将发展出一种亲密的耦合关系。 这一是为了让计算机助推人思维,二是在面对复杂情况决策时,可以让人机合作摆脱对既定程序的僵化依赖”②J. C. R. Licklider, “Man-Computer Symbiosis,” in Noah Wardrip-Fruin and Nick Montfort, eds., New Media Reader, Cambridge and London: The MIT Press, 2003, pp.73-82.。 在利克莱德的启发下,1962 年现代计算机科学和应用的先驱道格拉斯·恩格尔巴特(Douglas Engelbart)写下了开创性的《增强人类智能》,提出计算机应能成为辅助人类脑力劳动的工具。③Douglas Engelbart, Augmenting Human Intellect: A Conceptual Framework, Stanford Research Institute (SRI Project No.3578), 1962, https:/ /www.dougengelbart.org/content/view/138/000/, 2023 年12 月4 日。自此各种图、文、声音处理软件被开发出来;智力劳动开始被转移进数字媒介环境,在技术层面愈发依托“调用算法作用数据”的外置化、自动化机制。 在“增强人类智能”和“人机共生”的愿景下,计算机图形学的开创者伊万·萨瑟兰(Ivan Sutherland)于1962 年发明了人类第一款数字编辑软件“绘图板”,在其配套论文中,萨瑟兰把绘图板定位为“人机图形沟通系统”,而非仅仅是“画板”这一传统媒介到数字环境的延伸。④Ivan Sutherland,“Sketchpad: A Man-Machine Graphical Communication System,” in Noah Wardrip-Fruin and Nick Montfort, eds., New Media Reader, Cambridge and London: The MIT Press, 2003, pp.109-126.
不难看出,在这些计算机技术的早期缔造者这里,人的智能非但没有被吸收进机器,还将因为与机器的合作获得增强。 但这也意味着,无论人机耦合、共生还是沟通,人和机器都需要经过必要的磨合,理想的人机关系形态才能形成。 因而无论是在技术上还是在制度上,都需要留出一定通路,让人与机器的“协商”可能发生。 也因此苏瑟兰的绘图板是允许用户修改代码的,甚至阿兰·凯以“所有年龄段儿童”为目标设计人类第一款基于图形用户界面的个人电脑时,也开放了符合儿童年龄段认知能力的编程接口。 或许在阿兰·凯的畅想中,儿童学编程,就像儿童学数学一样,在未来将是一件再自然不过的事情。⑤Alan Kay, “A Personal Computer for Children of All Ages,” ACM '72: Proceedings of the ACM Annual Conference,vol.1, 1972, pp.1-11. https:/ /dl.acm.org/doi/pdf/10.1145/800193.1971922, 2023 年12 月4 日。只不过后来,随着信息产业勃兴,阿兰·凯在实验室发明的个人电脑,被苹果公司模仿来做了生意,苹果电脑相关软件的代码作为产品被封装起来,不再允许用户访问、修改。⑥Mitchell Waldrop, The Dream Machine:J. C. R. Licklider and the Revolution that Made Computing Personal, N. Y.:Penguin Books, 2002, pp.333-410.与此同时,微软之类的公司也成功把软件开发变成了买卖,在版权保护之下,代码从此像可口可乐的配方一样,以私有财产的方式存在,而软件也成为了代码不公开的私有软件(proprietary software)。
最终,随着信息产业发展,在强势营销手段的推动下,私有软件获得了垄断地位,成为了今天深入我们日常生活的“大众软件”,与此同时,大众软件也以便捷、流畅的名义,将“不要让我思考”(Don’t Make Me Think)的用户体验设计理念,上升为软件产业的主流标准,并进一步在私有软件的制度框架下,塑造着大众对“何为好的软件”“我能对软件做什么”的期待和想象。 于是,一方面,大众软件和消费文化以省事、舒适为诱惑,鼓励和帮助人类尽量避免思考,按照机器提供给他们的既定方案做事、做人。 另一方面,智能机器则不知疲倦地免费学习着由人类智力劳动和数字劳动成果积累而成的海量数据,推荐、监测、识别、生成等各项能力都变得愈发智能。 尤其近年来,以神经网络为代表的机器学习蓬勃发展,当推理、归纳、情感甚至类似人格的智能行为从机器涌现,机器智能本身也愈发对人展现为难以读取的技术“黑箱”。 就这样,在资本和权力对我们这个时代的技术、文化和人本身的系统性改造之下,人的智能被吸收进机器,人自身则愈发呈现出一种“系统性愚钝”的状态。 一句话,在机器变得愈发像人的同时,人也变得愈发像机器。 如果照此发展下去,又如何保证人的诸多脑力劳动,一定不会被机器取代?
那么情况是否有可能改善,下面,本文将从社会生产关系和人机关系两个方向,提出一种“增强人类智能”的可能设想。 在社会生产关系层面,正如马克思所言:
正像黄金不再是货币时,它不会丧失黄金的使用价值一样,机器体系不再是资本时,它也不会失去自己的使用价值。 决不能从机器体系是固定资本的使用价值的最适合的形式这一点得出结论说:从属于资本的社会关系,对于机器体系的应用来说,是最适合的和最好的社会生产关系。①《马克思恩格斯全集》第 31 卷,人民出版社1998 年版,第94 页。
将“机器论片段”追为鼻祖的左翼加速主义,面对21 世纪由信息技术驱动的人类社会发展现状,也在《加速主义宣言》中宣称“我们的技术发展正在受到资本主义压制,就像它曾被资本主义推动一样。 加速主义的基本信念是,技术的能力可以而且应该通过超越资本主义社会的限制而获得释放”。②Alex Williams and Nick Srnicek,“#Accelerate: Manifesto for an Accelerationist Politics,” in Robin Mackay and Armen Avanessian, eds., #Accelerate# : The Accelerationist Reader, Falmouth: Urbanomic Media LTD, 2014, p.361.那么,技术发展为什么正在受资本主义压制? 什么才是更适合数字时代“机器体系”的社会生产关系? 我们又是否能从技术的发展需要内部,找到这样一种生产关系?
不妨从谷歌今年5 月泄露的一份内部文件说起。 在这份文件中,一名谷歌员工写道:
我们一直在与 OpenAI 较劲。 谁先突破? 下一步怎么走? 但令人不安的是赢得这场军备竞赛的不会是谷歌,但也不是OpenAI。 我们掐架时,有人正闷声成长。 那就是“开源”。 坦率地说,开源正在超越我们……虽然我们的模型质量仍在一定程度上保持着领先,但差距正在光速减小。 开源模型的速度更快,可定制性更强,更能满足私人需求,而且在同等条件下能力更强。 他们正在用100 美元和 13 亿参数做着我们用 1000 万美元和 540 亿参数才勉强做到的事情。 并且,他们几周能搞定的事,我们可能要几个月。③“We have no moat, and neither does Open AI”, https:/ /www. semianalysis. com/p/google-we-have-no-moat-andneither, 2023 年12 月4 日。
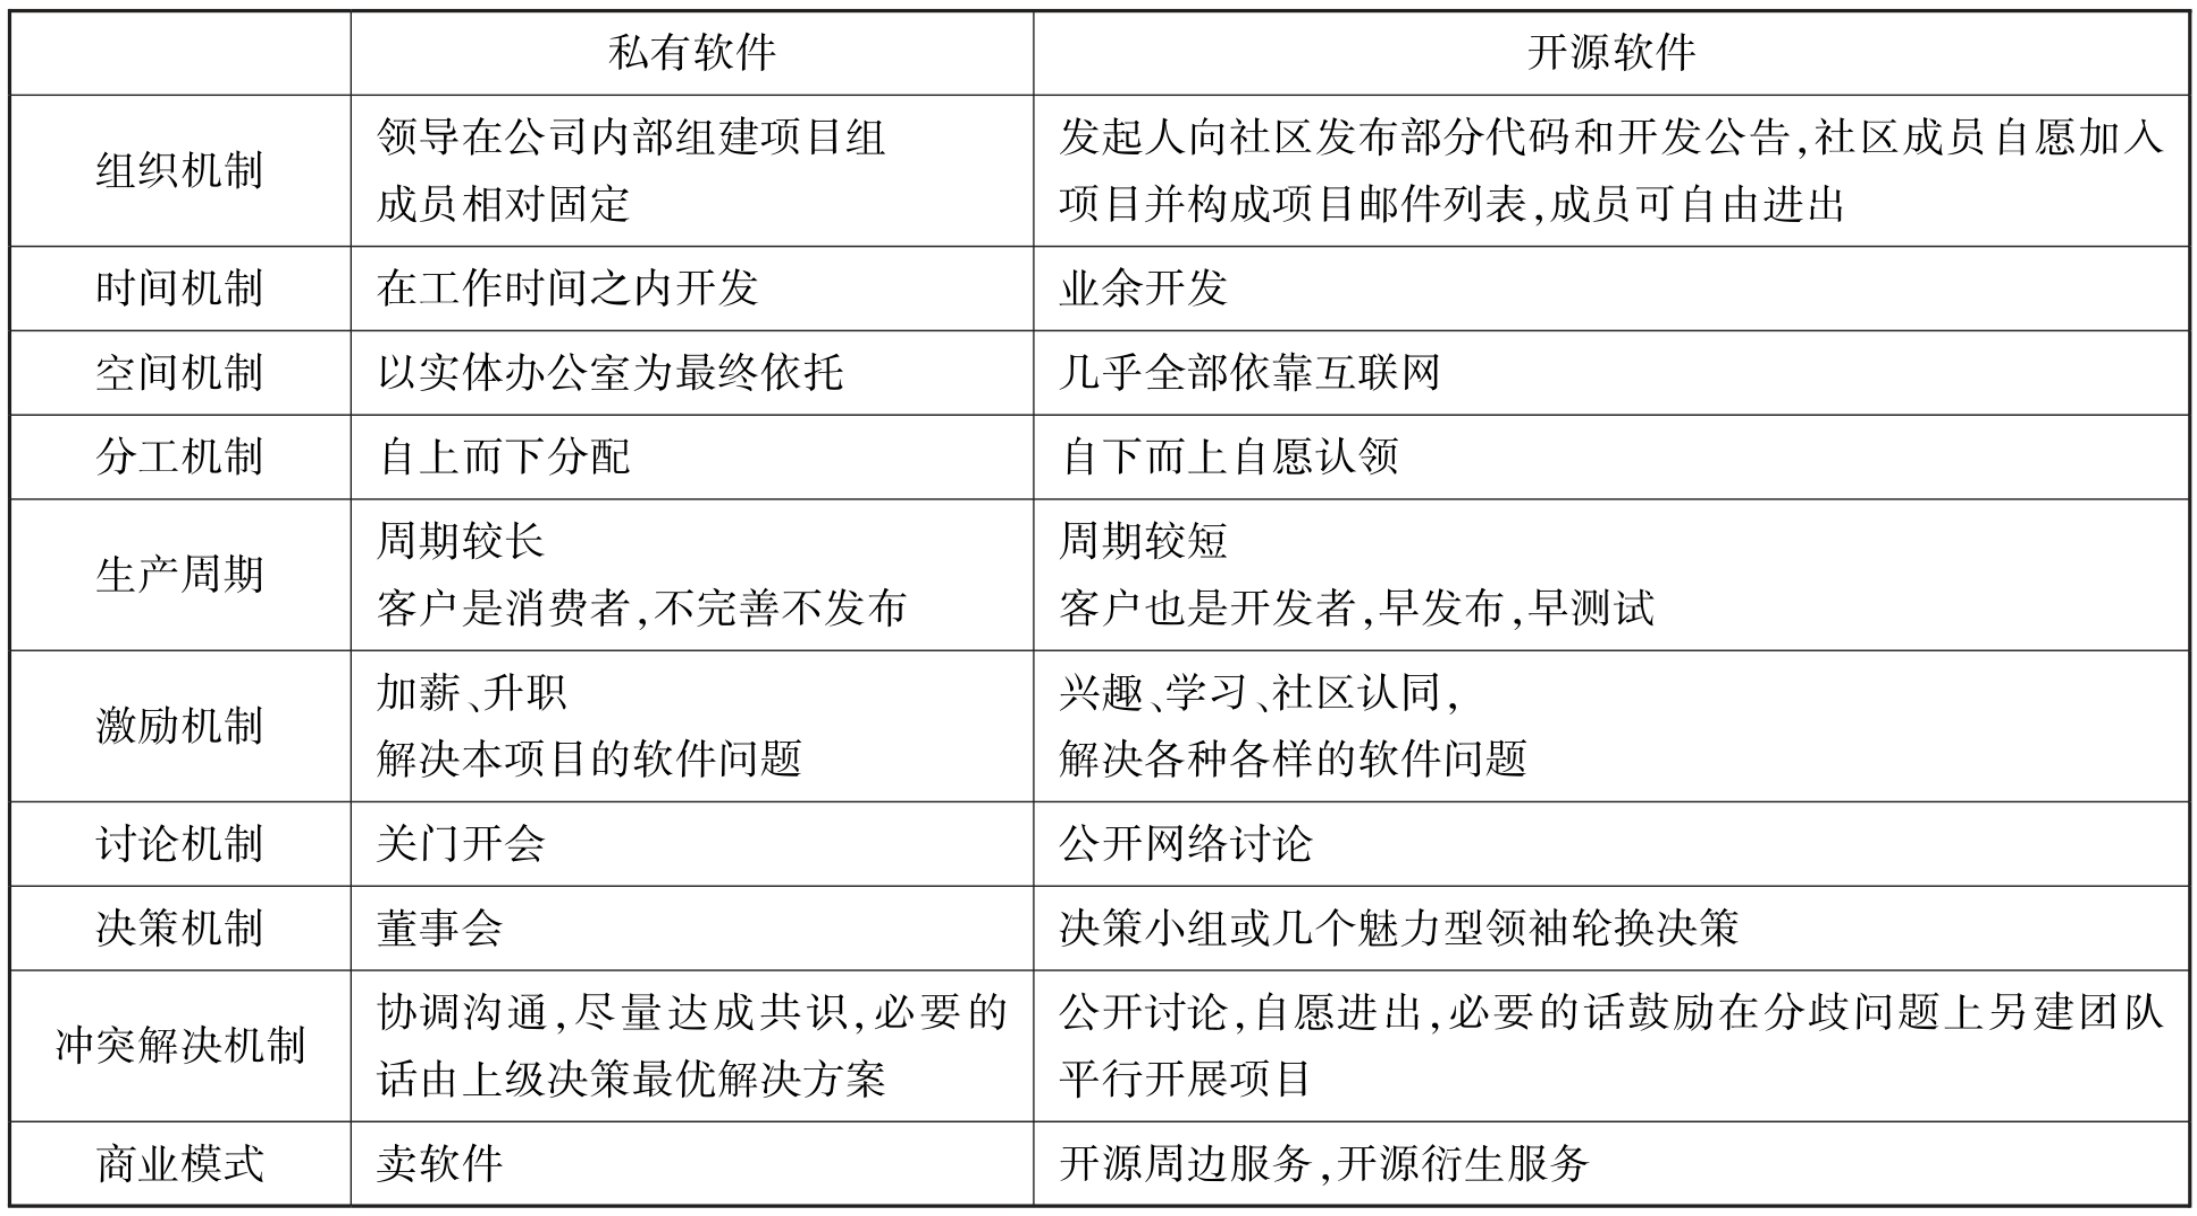
大模型训练需要大数据、大算力支撑,一度被认为是大资本的游戏。 其代表就是与微软有战略合作关系的ChatGPT 和由谷歌自主研发的PaLM。 但这份文件却声称,开源模型“正在超越我们”。 无论这份文件是否真的属实,它向我们展现了另一种可能:开源模型,而一些大模型测评也的确表示,LLaMA、Vicuna 等开源模型的当下表现,确实不比GPT 之类的私有模型逊色很多。①Alex Cabrera and Graham Neubig, Zeno Chatbot Report, https:/ /github. com/zeno-ml/zeno-build/tree/main/examples/chatbot/report, 2023 年12 月4 日。这里说的开源,指的是一种软件生产方式。 如果以微软为代表的私有软件开发需要层级式的管理、规范的流程、封闭的开发模式,产品的源代码也像私有财产一样不对外公开,风格有些像壁垒森严、层级分明的教堂;那么开源软件开发则需要社区自治、集体合作和可以让社区成员随时访问、调用和修改的源代码/数据库,风格有些像来去自由、结构扁平的集市(两种生产方式的比较见表1)。②参见埃里克·雷蒙德:《大教堂与集市》,卫剑钒译,机械工业出版社2014 年版,第21-58 页。
表1 传统软件和开源软件生产模式比较③此处主要根据Weber 在The Success of Open Source 中的描述总结。 参见 Steven Weber, The Success of Open Source,Cambridge and London: Harvard University Press, 2004, pp.99-106.
需要强调的是,开源运动虽少不了有着左翼情怀和信息时代精神的黑客推动,④Pekka Himanen, The Hacker Ethics, and the Spirit of Information Age, N.Y.: Random House Inc, 2001.但根本上还是内生于软件开发自身的需要。 首先,它根植于信息时代生产资料自身的特性,如果比特的复制、储存和传输像原子一样具有排他性或高损耗性,开源无论如何都难以成立。 其次,它也根植于信息时代生产活动本身的需要。 对于复杂的软件,查找bug 和解决问题极为费力,与此同时,一款软件经常要在不同环境下运行,解决系统兼容和功能拓展问题都需要额外调整代码。 所以开放源代码,一方面可以调动整个社区之力优化软件,另一方面,大家把成果都发布出来,也避免了各自为政、重复开发。⑤Steven Weber, The Success of Open Source, Cambridge and London: Harvard University Press, 2004.谷歌员工之所以在引文中认为“开源正在超越我们”,就是因为他充分认可在程序开发问题上,“开源社区”相对 “封闭公司”的优势。
正因开源生产方式内生于信息时代生产力自身的发展需要,这些年大资本对待开源的态度也经历了从忽视、抗拒到认可、利用的转变。 与此同时,也正因开源内生于生产力发展的需要,尽管经常面对大资本的围追堵截和笼络收编,开源依旧势不可当地构成了一种有异于私有软件及其产业形态的社区生态和技术文化,并进一步将其生产方式扩展到内容生产领域,带来了以维基百科等为代表的“用户生产内容”这一网络时代的标志性生产方式以及相关文化产品和生态的繁荣。①维基百科的出现直接受到了开源软件运动的影响。 维基百科的内容证书自2001 年以来的一个重要组成部分就是GFDL(GNU Free Document Licence)。 GNU 是由理查德·斯托曼(Richard Stallman)在1985 年创建的非盈利组织自由软件基金(Freesoftware Foundation)下的开源操作系统,GNU 直接领导了自由软件和开源运动,GFDL 本来是GNU 下开源软件相关说明文档的配套证书,后来该证书也延伸到了以维基百科为代表的内容领域,参见Andrew Lih, The Wikipedia Revolution, N.Y.: Hyperion, 2009, pp.72-73。 开源对互联网内容生产方式的进一步影响及其在中国的发展,参见秦兰珺:《论青年亚文化与互联网生产方式的互动》,《文艺理论与批评》2018 年第4 期。此时如果我们意识到,软件巨头用来训练私有大模型的海量数据,绝大多数其实也产生于“用户生产内容”这一开源模式在内容生产领域的延伸,②GPT-3 和PaLM 使用的语料约2000 亿个词和7800 亿个词,其中不乏像Github 代码、Wiki 百科、Wikidata、ArXiv论文、Reddit 论坛帖子等十分优质的开放获取资源。 参见饶高琦等:《语言资源视角下的大规模语言模型治理》,《语言战略研究》2023 年第4 期。那么我们完全可以说,无论是模型优化,还是数据训练,智能机器在信息时代的发展都正在且需要受惠于“开源”这种从信息社会内部涌现的社区友好而非封闭私有的生产方式。
因此比起“万模大战”谁最终胜出,谁又能成为通用人工智能的雏形,更重要的是关注这个未来的赢家,是否有可能最终属于社区、面向集体,进而真正做到让更多人受惠于AI 这一信息时代“一般智力”之主要表现形态。 信息时代被转移进机器的能力,本就根源于人类,受惠于网民,也应当属于更多人,而非沦落为极少数人以“服务大众”之名,剥削和控制绝大多数人的工具。 然而比起单纯秉持这种理念,更重要的是该理念并非没有依据。 这首先源于我们对“开源”这种内生于生产力发展需要的生产方式之了解。 正因那些以技术立身的软件巨头和互联网大厂,或许更理解“开源”这种信息时代的生产方式的意义,所以对“开源”往往抱以十分纠葛的态度:简言之,当他们以“工程师”的身份做决策时,常常更倾向开源,即便这种倾向与社会理念、人文理想无关,也有技术发展诉求支撑。 当他们以“资本家”的身份做决策时,就难免要倾向私有软件,可自家软件若无技术优势,又何来竞争优势? 当他们以“工程师”和“资本家”的双重身份做决策时,对待开源的策略就更加暧昧,从而给开源生态及其背后的技术文化、社会理想留下了一定的生存和发展的空间。
比如,著名的开源操作系统安卓就来自谷歌,此外谷歌还于2010 年收购了对于机器学习人类知识至关重要的Freebase,并于6 年后将所有数据捐给了维基百科的子项目“维基数据”(Wikidata)。③如果维基百科的受众是人,那么Freebase 强调的是机器可读。 作为专家系统的延伸,Freebase 将人类的知识表示为机器可读的结构化数据。 参见尼克:《人工智能简史》,人民邮电出版社2021 年版,第86 页。这些可以开放访问的、机器可读的结构化数据,就成了今天所有人都可以用来训练智能机器的重要数据来源。 而谷歌员工在上述信件中最终呼吁的,也无非是让谷歌重新承担起开源运动的推动者乃至领导者使命,尽管其动机或许不过是“让开源为我所用”,以免其他巨头借“开源”占了上风。 而这里的其他巨头,指的是Meta 等在人工智能上相对落后的公司。 2023 年3 月,Meta 推出了开源大模型LLaMA,并公开了其核心文档和代码,④Hugo Touvron et al., “LLaMA: Open and Efficient Foundation Language Models,” arXiv preprint arXiv: 2302.13971,https:/ /arxiv.org/abs/2302.13971, 2023 年12 月4 日。无论Meta 这样做的动机如何,实际效果却是推动了开源社区向大模型进军,各种开源模型从此不断涌现,其中很多都效仿LLaMA(llama 即羊驼),以驼类动物命名,由此形成了大羊驼(LLaMA)、小羊驼(Vicuna)、骆驼(Luotuo)等开源品牌,与GPT、PaLM 等私有大模型并立。⑤过去5 年世界上参数量超过百亿的大模型大约有45 个,其中有32 个出现在美国,9 个出现在中国,4 个出现在欧洲。 在美国32 个大模型中,有15 个开源。 中国的9 个大模型中有5 个开源,参见刘育英:《大模型掀热潮 中国着力打造开源生态》,中新社北京2023 年5 月29 日电,https:/ /www. chinanews. com. cn/cj/2023/05-29/10015597. shtml, 2023年12 月4 日。
至于处于风口浪尖的Open AI,自2019 年与微软达成战略合作关系,Open AI 从GPT-3 开始就不再开源,很多人认为它背离了最初写进其名字“Open”中的技术和社会理想,但Open AI 却这样对外声明:
虽然我们与微软的合作包括数百亿美元的投资,但OpenAI 仍然是一个完全独立的公司,由OpenAI Nonprofit 管理。 微软在我们的董事会没有席位,没有控制权。 而且,通用人工智能已经被明确从所有商业和知识产权许可协议中剥离出来。 这就是为什么我们选择微软开展技术和商业合作。 从一开始,他们就接受了我们有上限的股权回报,①Open AI 的投资者和员工的经济回报是有上限的(上限在每个有限合伙人的基础上提前协商)。 任何超额回报都归OpenAI Nonprofit。 这样设计是为了让Open AI 创造的大部分价值在实现后能惠及所有人,第一轮投资者的回报上限为其投资额的100 倍(与Open AI 2019 年面临的风险相称),随着Open AI 取得进一步成功,未来几轮投资的回报率会更低。 参见https:/ /openai.com/blog/openai-lp,2023 年12 月4 日。以及我们将通用人工智能技术及其管理留给非营利组织和全体人类的要求……他们能够理解我们的初心,能够明白这是一个独一无二且雄心勃勃的项目,这个项目需要公共资源的支撑,但更需要将其最终成果共享给所有人的自觉。②参见Open AI 的股权结构声明:https:/ /openai.com/our-structure,2023 年12 月4 日。
但必须看到,虽然OpenAI 是这样公开声明的,但它在资本要求下,是否并如何维护其不乏“开源”气质的公益“初心”,已成为一个举世瞩目的问题。
必须承认,很多情况下,资本支持开源,首先是一种出于自身发展需要的“战略”。③信息巨头支持开源主要基于以下两方面技术考虑:1.加入开源社区,可以更好地利用整个社区的劳动力,改善和维护自己的产品。 2.更能助推自己的产品成为一种行业“事实标准”,比如“安卓”和Chrome 就借助开源,在某种程度上成为了手机操作系统和浏览器领域的“事实标准”。 参见Bolun Zhang and Davide Carpano, “Chromium as a tool of logistical power: A material political economy of open-source,” Big Data & Society,Vol.10 (2023), Issue 1.但这里描述大资本与开源的复杂关系,不是为了展示资本在辩证运动中对其“对立面”的吸收能力。 本文更试图表达的是,当我们沿着马克思的思路,提出信息时代的机器体系可以并应该拥有更适合它的生产关系时,当左翼加速主义宣称,技术的能力可以且应该通过超越资本主义社会的限制获得释放时,这种观念并非没有历史唯物主义方法支撑的理论臆想。 一方面,“开源”生产方式的基础,是生产资料乃至产品的社区化、公共化,这让它不同于主流的资本主义生产方式。 另一方面,开源也并非一种自上而下的先验“设计”,它内生于信息时代的生产实践,也符合信息时代生产力发展的需要本身。 正因如此,开源是有可能构成信息时代另类生产关系之“原型”和基础的。
当然,为了能够让信息时代的机器体系,不落入资本和权力的控制,仅仅指望资本出于自身目的给差异生产关系留下“活路”,是远远不够的。 它的实现,需要理论和实践的双重创造,需要更多人身体力行的践行和推动。 具体到我国,由于“自主可控”“可信人工智能”等科技发展战略,对开源软件及其支撑文化的态度近年来十分积极。 2021 年工信部发布《“十四五”软件和信息技术服务业发展规划》,对“开源重塑软件发展新生态”进行了充分肯定,提出到2025 年“建设2-3 个有国际影响力的开源社区,培育超过10 个优质开源项目”。④《“十四五”软件和信息技术服务业发展规划》,https:/ /www. gov. cn/zhengce/zhengceku/2021-12/01/5655205/files/a44b507d67c74591ad4f5e55b98c4518.pdf, 2023 年12 月4 日。目前我国已成为全球开源生态的重要贡献力量,参与国际开源社区协作的开发者数量排名全球第二。 “开源鸿蒙”(OpenHarmony)、“开放麒麟”(openKylin)等本土开源项目及其背后的开源社区也正在孵化。⑤黄鑫:《“十四五”软件业开源生态加快构建》,《经济日报》2021 年12 月6 日,第6 版。北京市政府最新发布的《北京市加快建设具有全球影响力的人工智能创新策源地实施方案(2023—2025 年)》则把“鼓励相关技术和算法开源开放”作为“突破人工智能关键技术、引领产业高水平发展”的导向。⑥《北京市加快建设具有全球影响力的人工智能创新策源地实施方案(2023—2025 年)》,https:/ /www. beijing.gov.cn/zhengce/zhengcefagui/202305/t20230530_3116889.html,2023 年12 月4 日。在政策导向和技术发展诉求的通力作用下,清华大学的ChatGLM-6B、复旦大学的MOSS、智源研究院的“悟道”、百川智能的Baichuan 大模型系列等国内领先的大模型纷纷走向了开源战略。
当然为了延续“增强人类智能”的事业,除了在宏观上探索更好的社会生产关系,微观上的主体行动也不可或缺。 宏观层面的社会生产关系,本就需要微观层面的主体行动参与和支撑。 而这种参与,也必将需要重建人与机器的更本质、更深刻的关联。 其实西蒙东在《论技术物的存在模式》中就曾指出,马克思的技术哲学在偏重政治经济批判的同时,忽视了对人与机器之间更根本的关系的探讨,而斯蒂格勒以《技术和时间》为代表的一系列工作就是对这种“人与机器之间更为根本的关系”的继承和发展。①参见 Gilbert Simondon, On the Mode of Existence of Technical Objects, trans. Cécile Malaspina and John Rogove,Minneapolis: Univocal Publishing, 2017,p. 16;许煜:《马克思、西蒙东与自动化的政治》,《马克思主义与现实》2018 年第6 期。那么建立这种更为根本、也更理想的人机关系需要从哪些方面入手? 这是一个现阶段尚难回答的问题,但这里不妨从这种理想关系的反面说起。
1929 年两位科学家将一只活猫大脑固定在实验装置中,将其听觉神经接入了电话线,科学家在猫耳边制造声音,猫耳蜗将声波转化为神经电信号,经由听觉神经流入电话线,又在电话线的另一头转化为声波,被人听到。②Wever, E. G. & C . W. Bray, “The Nature of Acoustic Response,”Journal of Experimental Psychology, Vol. 13,No.5, 1930, pp.373-387.在这个由生物和电路构成的“活猫电话”中,猫被化简为机器的信号转换和传输部件,主体性消失殆尽。 但这只近100 年前被接入机器的控制论有机体,难道不是在某种程度上也预言了今天的人的可能处境吗? 在这种处境中,机器是创造和行动的主体,人则被动接入机器,成为机器的延伸。 那么究竟是什么造成了生命与机器的上述“暗黑”关系? 当然,最直接的原因肯定是那个字面意义上的机器装置,但猫之所以被固定在这台装置上动弹不得,难道根本上不是因为人的强力所致? 在这里,人类“科学机器”的运作通过“实验机器”的运转发挥作用,一种大写的主体意志与大写的机器编码合二为一。 因而,造成生命上述处境的机器,不仅是字面意义上的机器,也是隐喻意义上的机器,是暴力机器、资本机器、官僚机器,是各种“机器”的相互缠绕和通力作用,最终导致了生命被绑缚在“机器复合体”上,成为了机器可资利用和吸收的生物资源。
两千多年前,孟子的“率兽食人”可能发展成自动化时代的“率机食人”吗? 改善这种“暗黑”人机关系,需要在各个层面,跳出上述“机器为主动形式、生命为被动质料”形质二元(hylomorphism)关系,恢复生命与机器的协商能力。 因为这里的机器是复合机器,所以这里的协商也注定是复合协商:在技术层面,它不仅需要工具代码在一定程度上向社区公开,更需要更多人拥有监督和修改代码的意愿和能力,而这种意愿和能力也正是上述另类社会生产关系在微观个体层面的基础。 或者说,微观层面更好的人机关系本就是通向宏观层面另类生产关系的保障。 在应用层面,它需要我们跳出多年来“被动应答”的惯性,学会用建立在主体性上的提问,引导人机交互中的精神生产,并进一步在人机磨合中,让智能机器成为辅助我们脑力劳动的“上手”工具③“上手”描述的是一种技术物在人的直接经验中抽身而去的状态。 现象学总体认为,人是在与世界的关系中认识自己和世界的,不存在独立的主体与客体。 在海德格尔的运思中,技术就可以见证这种存在方式的开显。 他以锤子为例,提出锤子正常使用时,是不会成为“对象”的。 只有锤子损坏时,人才会意识到“锤子”,因为“切近的上手事物的特性就在于:它在其上手状态中就仿佛抽身而去,为的恰恰是能本真地上手”(海德格尔:《存在与时间》,陈嘉映、王庆杰译,三联书店2006 年版,第82 页)。。 比如,最近成为热点的“提示工程” (prompt engneering)④提示工程是一种为生成式AI 撰写文本提示,以保证AI 正确生成人们所需要的输出成果的工作流程,从事此工作的人又被称作“提示工程师”。就是在提问和写提示词上寻求人类主体性的一种尝试。 在制度层面,它需要我们能与技术编码背后的制度编码协商,否则最发达的机器体系很可能只会“迫使工人比野蛮人劳动的时间还要长,或者比他自己过去用最简单、最粗笨的工具时劳动的时间还要长”⑤《马克思恩格斯全集》第31卷,人民出版社1998 年版,第104 页。,把人更深地卷入野蛮的制度。 为此在文化层面,它需要我们拥有更强的自我管理、民主监督和协商能力,“这需要我们把政治生活与启蒙遗产结合起来,我们需要更好地理解自己、理解世界(我们的社会、技术、经济和心理世界),只有当这种理解能力得到真正培植,我们自己当家做主的日子才能到来”①Robin Mackay and Armen Avanessian, eds., #Accelerate# : The Accelerationist Reader, Falmouth: Urbanomic Media LTD, 2014, p.358.。
然而所有协商的前提,都需要我们首先——用维纳(Norbert Wiener)的话说——“把人当人”(the human use of human beings)。②参见维纳:《人有人的用处:控制论与社会》,陈步译,北京大学出版社2010 年版。因为在各种强横的机器前,只有人首先自己尊重自己,人才有可能作为一个行动主体,与各种意义上的“机器”建立协商关系,才有可能在更理想的人机交互中,借技术获得人的增强乃至解放。 换言之,如果我们不以人的方式从事更高水平的精神生产,那么就不要抱怨我们的低水平重复劳动,有一天可能会被吸收了人类智能的机器取代。 如果我们不以人的主体性抵抗各种“率机食人”的异化,那么就不要怪我们因自己的懦弱卷入机器齿轮,最终成为一个行尸走肉般的人肉部件。 换言之,心智强大的人,这不仅是“增强人类智能”最终试图达成的美好愿景,更是这个愿景在不同层面的人机博弈和协商中如愿实现而不至走形的前提。
最后,让我们回到贯穿本文的两个根本问题。 第一个问题是我们为何可能被取代? 因为自动化机器是转移了人之劳动能力的机器,如果机器变得愈发像人,人却自甘在资本和权力的塑造下变得愈发像机器,那么处于“系统性愚钝”状态、只能进行低水平重复劳动的人,就的确可能被更智能和高效的劳动主体——智能机器——取代,虽然这可能会逼着人类社会提升失业救济能力,但若放在历史长河中来看,这种“大浪淘沙”本身,或许并没有我们当下感到的那么遗憾。 第二个问题是我们如何才能被增强?增强人类智能的事业,需要首先在宏观上从信息社会内部,发展出一种超越资本主义限定的更好的社会生产关系,让凝结在智能机器中的人类能力朝着造福人类的方向发展,而非沦为少数人控制更多人的工具;同时也需要我们在微观上培育与不同层面的“机器”进行协商的意愿和能力,我们应该把人机关系建立在这种深度协商和有效磨合之上,而非人对机器之运作逻辑、机制、功能、要求的单方面接受之上。
之所以提出上述两个问题,的确是因为笔者感到,技术已经再次发展到了一个让我们不得不去提问的阶段。 虽然我们无法确定,信息革命时代的智能机器是否就如工业革命时代的蒸汽机,已具备重塑人类社会的潜能,但可以肯定的是,无论变革是否真的发生,都需在智识上做好准备。 而辨证唯物主义和历史唯物主义的方法,总能将技术与人的发展以深刻而丰富的方式关联起来,将技术与人的关系放在更壮阔的历史运动和更宏观的社会结构中考察,并最终在理解现实的基础上,为我们指出化危机为契机的可能方向。
作者简介: 秦兰珺,中国艺术研究院马克思主义文艺理论研究所副研究员,文学博士。
基金项目: 本文系国家社会科学基金重大项目“当代新兴增强技术前沿的人文主义哲学研究”(20&ZD045)的阶段性成果。
(责任编辑:若峦)

