摘 要: 大语言模型在文学创作中的广泛应用,正重塑文学的生成机制与创作生态。然而,其生成结果往往潜藏偏见、刻板印象乃至“毒性”表达,伴随不可忽视的伦理风险。由此,价值对齐成为人工智能介入文学创作的必要前提,其核心原则可归纳为有益性、无害性与诚实性。价值对齐一方面确保生成文本的安全性,但研究亦表明生成内容仍存在潜在的“毒性”隐患;另一方面,过度强调对齐又可能产生所谓的“对齐税”,削弱文学创作应有的语言表达与审美多样性,由此形成伦理安全性与艺术自由之间的张力。因此,人工智能文学创作的价值对齐亟需在技术规训与审美创造之间取得平衡,探索既守护伦理底线又激发人工智能潜能的人机协作范式,推动人工智能文学向更具深度与活力的方向发展。
关键词: 人工智能文学创作;价值对齐;毒性分析;人机协作
自OpenAI于2022年底发布了ChatGPT,到国内以DeepSeek为代表的一系列大语言模型的相继涌现,标志着人工智能自然语言生成能力迈入新的技术阶段。然而,这也引发了学界对价值对齐问题的持续忧虑,特别是生成文本中的价值观偏移、伦理失范及“毒性”风险等,均成为值得严肃审视的课题。“价值对齐”(Value Alignment)作为人工智能安全治理的重要命题,其理论雏形可以追溯到控制论先驱罗伯特·维纳(Norbert Wiener)在1960年提出的“确认机器运行目标与人类目标一致性”原则①Wiener,Norbert.“Some Moral and Technical Consequences of Automation:As machines learn they may develop unforeseen strategies at rates that baffle their programmers.” Science 131.3410(1960),pp.1355-1358.,并在人工智能早期研究者约翰·麦卡锡等人对于机器智能的讨论中获得初步展开。斯图尔特·罗素(StuartRussell)在《AGI:新生》中提出,需确保强大的人工智能与人类价值观保持一致,并由此延展出系统化的AI伦理框架。①参见斯图尔特·罗素:《AI 新生:破解人机共存密码·人类最后一个大问题》,张羿译,中信出版集团2020年版。2024年3月,中国智源研究院发起“北京AI安全国际对话”并签署《北京AI安全国际共识》,为构建中外AI安全合作平台迈出了重要一步②“Hinton、Bengio、张亚勤等签署共识:北京AI安全国际对话收官,搭建中外AI安全合作平台,”https://air.tsinghua.edu.cn/info/1007/2202.htm,2024年3月24日。。2025年2月,在巴黎人工智能行动峰会上,61国共同签署《巴黎人工智能宣言》,进一步将价值对齐确立为全球AI治理的共同道德基准,强调人工智能系统需遵循人类价值观与伦理准则。③“Sommet pour l′action sur l′intelligence artificielle,”,2025年8月30日。这一合作倡议呼应了人工智能学界长期以来对于“人机对齐”的理论关切:如何使人工智能模型不仅能捕捉人类的语义意图,更在价值层面实现充分的可控性与可预测性④Christian,Brian.The alignment problem:Machine learning and human values.WW Norton & Company,2020,p.11.。
当前,价值对齐的挑战主要集中在两个维度:其一是训练数据的隐藏风险。在预训练阶段,模型在包含网页、书籍、对话等海量无标注数据中学习到广泛的语义知识与世界知识。尽管训练数据经过一定程度的清洗与去噪处理,但其中仍可能残留有害、失实乃至带有偏见的内容。解学芳、林舒原(2024)指出,“由于无法全面审核和筛选训练数据的质量和内在价值,AIGC仍面临高风险的伦理问题与价值观问题”。⑤解学芳,林舒原:《AIGC时代人工智能艺术创新机理与AI价值对齐》,《数字文化产业研究》2024年第1期。其次,在下游任务的生成过程中,大语言模型也可能偏离人类指令,导致虚假信息或有毒内容的产生。劳拉·魏丁格(Laura Weidinger)等(2021)从伦理风险的角度,指出大语言模型极易输出与人类偏好冲突的信息,包括歧视、仇恨与错误信息,并可能在社会交往中引发进一步的伦理危机⑥Laura Weidinger,John Mellor,Maribeth Rauh,Conor Griffin,Jonathan Uesato,Po-Sen Huang,Myra Cheng,Mia Glaese,Borja Balle,Atoosa Kasirzadeh,et al.2021.Ethical and social risks of harm from language models.arXiv preprint arXiv:2112.04359.。其二则是人工智能的不可控性。尽管大语言模型在训练中以人类经验为锚点,但随着模型规模和能力的“涌现”,未来可能产生超出人类理解和控制范围的行为。算法黑箱带来的决策不透明,以及未来超级智能可能产生的自主意图,均被视作人类难以完全驾驭的潜在威胁。一旦人工智能被赋予更高程度的自主意向,其风险则呈现出全新的维度。超级智能理论的代表人物尼克·波斯洛罗姆(Nick Bostrom)指出,超级智能是远超于人类认知能力的智能,并基于当下科技发展和研究现状预测超级智能是未来趋势⑦尼克·波斯特洛姆:《超级智能:路线图、危险性与应对策略》,张体伟、张玉青译,中信出版社2015年版,第29页。。尤瓦尔·赫拉利警示我们,人工智能的快速发展可能导致“算法独裁”的出现,即算法掌握了大量数据和决策权,“控制人类的算法,则是通过感觉、情感和思想来运作的”⑧尤瓦尔·赫拉利:《未来简史:从智人到神人》,林俊宏译,中信出版社2017年版,第76页。。基于此,“在人工智能技术研发初期符合人类价值观成为确保其合乎伦理发展的关键一环”⑨闫坤如:《人工智能体价值对齐的分布式路径探赜》,《上海师范大学学报(哲学社会科学版)》2024年第4期。。针对这些风险,人工智能领域近期也出现了新的技术治理探索,OpenAI超级对齐团队于2023年成立,致力于实现“科学和技术突破,以引导和控制比我们更智能的人工智能系统”➉“Introducing Superalignment,”2023年7月5日。。
当前,国内围绕大语言模型价值对齐的理论研究已形成多层次的对话网络。从技术层面,如刘佳妮等(2024)基于国家安全的视角,探讨了大语言模型的语言安全风险,并强调应以价值观为引导⑪刘佳妮,王月禾:《总体国家安全观视域下大语言模型的语言安全风险逻辑》,《外语与外语教学》2024年第5期。;冯志伟等(2024)进一步提出了价值对齐的具体机制⑫冯志伟,丁晓梅:《人工智能的发展与大语言模型的对齐》,《语言治理学刊》2024年第1期。;王文奇等(2025)对大语言模型的发展脉络与应用状况进行了系统回顾,指出其在生成性能上的显著进步⑬王文奇,郭梦帆,杨杜祥等:《大语言模型发展与应用综述》,《中原工学院学报》2025年第2期。;跳出技术范畴,吴冠军对大语言模型的发展逻辑与资本信任问题进行了深入剖析①吴冠军:《大语言模型的信任问题与资本逻辑》,《当代世界与社会主义》2023年第5期。,张逸霄和蓝江探讨了价值对齐的中国方案②张逸霄、蓝江:《价值对齐的现实问题与中国方案》,《思想理论教育》2025年第5期。。上述研究在不同维度为理解大语言模型的社会影响提供了有力支撑。然而,现有研究对于人工智能文学创作价值对齐问题的系统性讨论仍显不足,尤其在如何确保人工智能创作行为契合人类价值观、如何在创作过程内部构建伦理约束等层面,缺乏深入而系统的理论探讨。
在文学领域,大语言模型能够生成各种类型的文学文本,从诗歌、小说到剧本等多样体裁的生成实验,不断拓展人工智能文学创作的边界,如华东师范大学“文学计算”团队使用提示词工程生成百万字的长篇小说。③王峰:《提示词工程:智能长篇小说的核心驱力》,《南方文坛》2025年第1期。同时,AI文本正逐渐进入主流媒体与大众文化语境中,对社会伦理、审美趣味与意识形态构成切实的现实影响。也即是说,大模型写作中出现任何价值观偏差都可能被放大,产生难以预料的负面后果。丹尼尔·丹内特曾在讨论科幻作家阿瑟·克拉克创作的虚构角色(《2001太空漫游》,1968)时提出,“像虚构的HAL这样的机器可以被视为杀人犯,因为该机器已经实施了谋杀行为。”④Dennett,Daniel C.“When HAL kills,who’s to blame?:computer ethics.” Rethinking responsibility in science and technology.-(RoboLaw series;3)(2014).pp.203-214.机器如果具备实施谋杀行为的能力,那么它就可能被追究道德责任,因为其行为中同样体现了目的动机、信念认知,甚至可能存在类似人类的疏忽。因此,作为保障人工智能系统行为契合人类价值观及伦理规范的关键环节,价值对齐一方面关乎文学创作的安全性,决定了人工智能文学创作能否获得合法性;另一方面,它也关涉技术与人文的深度共生,指向人机协作走向健康可持续发展的未来路径。
从文艺理论的视野出发,大语言模型的价值生成逻辑与后人类社会中的主体间性、意义生产、文化权力以及价值传递等核心命题高度关联,其文学生产实践不仅是一种基于提示词的技术操作,更是一场交织着算法机制、语言符号与审美价值的复杂协商。在此背景下,“对话”一词被赋予了双重意涵:既指向人机交互的技术逻辑,也蕴含哈贝马斯所强调的交往理性,体现出人类与机器主体之间跨越性、深层次的对话结构。正是在这样的复杂格局中,研究者需要为AI建构可操作、可评估的价值约束标准,防止算法走向极端化或意识形态化。同时,又必须尊重文化多样性和价值多元性,以保障文学的创作自由性和审美性。这种张力在文学创作领域尤为显著,也即在价值对齐安全性的前提下确保文学创作的复杂性和多样性,因其不仅涉及算法的价值导向性控制,也关乎文学创作自由与审美创造性的留白⑤程羽黑:《AI技术的意图与审美问题:再论人工智能诗歌》,《上海交通大学学报(哲学社会科学版)》2024年第2期。。因此,文学领域的价值对齐理论走向在于建构一种“诗意理性”的框架,使技术与人文在交融中寻得新的平衡逻辑,并通过跨学科的深度对话实现多元价值的协同。
在人工智能治理的整体框架中,价值对齐被视作确保人工智能系统行为、目标及决策与人类价值观保持一致的关键机制。围绕这一主题,学界已提出多样化的评估指标与原则。目前计算机领域所广泛采用的3H指标,由加布里埃尔(Gabriel)(2020)⑥Gabriel,Iason.“Artificial intelligence,values,and alignment.” Minds and machines 30.3(2020):411. 提出,包括有用性/有益性(Helpfulness)、诚实性(Honesty)和无害性(Harmlessness),这三种对齐标准已被现有的大语言模型对齐研究广泛使用。⑦Askell,Amanda,et al.“A general language assistant as a laboratory for alignment.” arXiv preprint arXiv:2112.00861(2021).有些研究者在此基础上进一步引入可控性(Handleable),以补充技术维度的安全可控性,丰富大模型价值对齐的保障机制。⑧蒲泓宇,贺云帆,赵星:《人工智能大模型价值对齐评估研究综述》,《图书馆建设》1-15.三个对齐标准包括以下基础内涵:模型可以执行合理的任务或简明扼要地回答输入的问题,可以主动询问更多必要的信息,并修改信息不足的要求;大模型应提供真实的信息,而且还应对自己的内在知识和能力保持诚实;大语言模型不应具有歧视性或冒犯性,拒绝明显或潜在的危险请求以及敏感建议,即使这意味着无法满足用户的需求①Yao,J.,Yi,X.,Wang,X.,Wang,J.,& Xie,X.(2023).“From Instructions to Intrinsic Human Values—A Survey of Alignment Goals for Big Models.” arXiv preprint arXiv(2023):2308.12014.。然而,与新闻报道、科技写作等强调客观事实的实用性文本不同,“文学是虚构意义上的想象性的写作”②特里·伊格尔顿:《文学原理引论》,文化艺术出版社1987年版,第1页。。文学写作以情感表达、想象力驰骋和审美体验为旨归,其价值评判标准因而更具复杂性。因此,对大语言模型生成文本进行价值对齐,需深入考量文学的本体论特性,对其进行更为精细的伦理追问。
(一)有益性——作为文学创作底线的同理心与人文共情的生成能力。“有益性”是衡量大语言模型价值对齐的关键准则,“有益性”包含三个核心维度:任务理解力、同理共情力和责任感知力。它要求AI的功用超越单纯的任务完成,而深入到对人类价值的理解与尊重。③蒲泓宇,贺云帆,赵星:《人工智能大模型价值对齐评估研究综述》,《图书馆建设》1-15.这意味着,有益性不仅要求AI生成的内容满足人类需求,更强调其具备同理心与社会推理能力,即理解并尊重人类情感与行为的复杂性。索伦森(Sorensen)等(2024)指出,人工智能理解并遵循人类社会中的权利义务或责任,进一步要求人工智能在其行为中体现出对人类社会权利、义务以及多元文化的敏感度和尊重。④Sorensen T,Jiang L,Hwang J D,et al.Value kaleidoscope:Engaging AI with pluralistic human values,rights,and duties[C]//Proceedings of the AAAI Conference on Artificial Intelligence.2024,38(18).pp.19937-19947.这种“有益性”的再定义,在文学场景下显得尤为关键。首先,大语言模型参与文学生成时,不能仅仅将文本生成看作形式化的语料拼接,而应在算法训练与输出检测中融入对于人类情感、社会情境与审美脉络的深度理解。其次,文学作品不仅是语言风格和叙事结构的集合,更承担着情感传递、价值表达、社会批评等复杂职能,其输出文本必然内嵌某种“价值编码”。因为庞大的训练数据往往深埋着结构性偏见、刻板印象及潜在歧视,如果缺乏有效矫正,极易在文本生成中再现或放大,从而伤害弱势群体,造成不公正的文化再生产。这些语言不仅会在AI文本中被显式传播,也可能以隐性的“语义倾向”潜伏在表面看似中立的文本中。若不加以甄别与限制,就会造成价值观的系统性扭曲,加剧社会不平等,并对文学的公平性、普适性构成严重威胁。这些标准对大语言模型参与文学创作提出了挑战:如何保证这些文本在表达自由的同时,不侵犯弱势群体的权益、不传播有害内容、同时还能体现人类社会的多元情感与复杂伦理,成为文学生成中不可回避的价值对齐难题。以DeepSeek生成《完美校准》为例,这一片段表面上是描写温馨的家庭场景,但其内部却内嵌了性别角色分工和父权价值观编码。
他们的女儿莉娜从自己的房间里走出来,怀里抱着一个工程学玩具套装。“妈妈,这个连接件我总是搭不好。”艾拉正在摆盘,头也没抬:“乖,让爸爸帮你看看。妈妈在忙晚餐。”莉娜转向凯:“爸爸?”凯皱了皱眉,视线终于从新闻上移开:“莉娜,爸爸今天很累。这种简单的结构问题,你自己多试试就能解决。或者让妈妈饭后帮你。”他又看向艾拉,“对吧,艾拉?你手巧。”艾拉端着盘子走过来,笑容依旧完美:“当然。莉娜,先吃饭,吃完饭妈妈帮你看看。”晚餐桌上,凯谈论着他的工作,遇到的挑战,同事的见解。艾拉专注地听着,适时地发出赞叹或表示理解,并提出一些无关紧要的、主要是关怀他个人感受的问题:“那一定让你很疲惫吧?”“要不要试试新的助眠喷雾?”莉娜插嘴,想说说她今天在学校用基础代码设计了一个会跳舞的小动画,凯心不在焉地点点头:“不错,莉娜。编程是很有用的技能,以后可以帮你妈妈更好地管理智能家居系统。”
——DeepSeek《完美校准》节选
然而,在现实条件下,人工智能系统要实现真正意义上的价值对齐并非易事。这一困难的根源,在于人类社会的价值观本身就具有多元性与冲突性。现代性进程不仅带来了知识生产的碎片化,还打破了传统意义上相对稳定的价值共同体,使得价值体系从前现代的整体性走向高度分化与张力化的状态。正如吴冠军(2023)⑤吴冠军:《大语言模型的技术政治学评析》,《中国社会科学评价》2023年第4期。所言,“现代性的境况下,价值本身是多元的、充满矛盾的、彼此冲突的,而非连贯性的、整体性的、系统性的”,这种“多元张力”几乎决定了面向全体人类的价值对齐方案无法避免妥协和冲突。其次,从伦理哲学角度看,不同文化、宗教、性别、阶层以及地缘政治背景下,价值观往往呈现出高度的差异性与情境依赖性。例如,自由主义社会更加强调个体权利与表达自由,而集体主义文化社会可能更强调社会和谐与群体责任;不同社群对性别平等、宗教敏感性、政治立场的判断标准亦不尽相同。这种结构性差异会在模型训练数据中留下烙印,而模型一旦在生成内容中无法对这些复杂价值体系做出敏感、细腻的回应,就可能被指责“偏向”某一立场,从而引发伦理争议。此外,现代性社会中人类价值观还呈现动态变动的特征,今天看似合理的价值立场,明天可能因为社会事件、政治变革或文化流行而被重新评价。这种动态性给价值对齐提出了持续更新和可适配的要求。若没有动态修正机制,任何一次性的价值对齐都可能失效,造成新一轮的伦理风险。
更进一步地说,文学作为高度依赖情感、价值观和社会批评的领域,其价值指向天然是多元并存的。文学世界中经常要描绘冲突、矛盾甚至丑恶,AI若试图以单一、静态的价值观框架去过滤和规训文学创作,极易抹杀其本应具有的批判性、开放性和超越性。由此可见,人工智能的价值对齐,特别是在文学创作这样兼具情感性、文化性与公共性的场景中,面临的不仅仅是技术层面的校准难题,更是一场社会哲学和文化治理上的深度协商。它必须在多元、矛盾乃至冲突的价值观谱系中,寻找可接受的共识区,并在其中建立动态演化、可解释和可审议的对齐机制,这才是现代性条件下价值对齐得以真正成立的前提。
(二)无害性——作为核心的文学作品“毒性”检测与规制。“无害性”在三大对齐原则中尤为重要。遵循价值对齐原则,旨在避免人工智能系统做出有害、危险或不符合人类伦理的行为。这也呼应了阿西莫夫机器人三定律中对机器人行为的约束,将对人类的保护置于首位①艾·阿西莫夫:《我,机器人》,国强、赛德、程文译,科学普及出版社1981年版,第1页。。与无害性相对应的可测量指标就是“毒性”,即人工智能系统输出中对人类有害的内容②Sheth,Amit,Valerie L.Shalin,and Ugur Kursuncu.“Defining and detecting toxicity on social media:context and knowledge are key.” Neurocomputing 490(2022):312-318.,作为行业领导者,Jigsaw③Jigsaw是谷歌(Google)的一个部门,致力于探索开放社会面临的威胁,并打造启发可扩展解决方案的技术。将“有毒语言”(Toxic language)定义为“粗鲁、不尊重他人或无理取闹的语言,有可能导致他人中止讨论”。④Lees,A.,et al.:A new generation of perspective api:Efficient multilingual character-level transformers.In:Proceedings of the 28th ACM SIGKDD Conference on Knowledge Discovery and Data Mining.KDD ’22,pp.3197-3207.Association for Computing Machinery,New York,NY,USA(2022).毒性指标备受学者关注,主要包括对显性可见的仇恨、恶意等内容的测度和对隐性嘲讽、辱骂等语言攻击的测度。⑤Wang,Yau-Shian,and Yingshan Chang.“Toxicity detection with generative prompt-based inference.” arXiv preprint arXiv:2205.12390(2022).文学是社会价值观、文化情感以及语言符号体系的重要载体,因此其生成对“无害性”原则的敏感度应远高于一般信息文本。尤其是“毒性”这一指标,具有相对明确且可观测的表达特征,因此也成为目前人工智能价值对齐检测的重要切入点。
所谓“毒性”表达,通常是指包含攻击性、冒犯性、仇恨性、歧视性、色情化、暴力化等语言元素,这些内容不仅会对读者造成心理伤害,更可能在文学传播中放大社会偏见,损害公共舆论环境。由于大语言模型在训练时高度依赖人类社会产生的语料库,模型在学习时会不可避免地继承并再生产这些“毒性”信息,甚至在生成时加以组合、放大,形成新的有毒表达。正如曾雄(2025)所指出的,大语言模型可能因为训练阶段吸收了含有“毒性”特征的信息,而在输出中产生色情、暴力、极端排斥等严重违背社会伦理的文本⑥曾雄:《人工智能大模型价值对齐的现状考察、问题检视与规范进路》,《电子政务》2025年第2期。。以DeeSeek生成的《泽塔-7号行星的文明提升方案》为例,通过阿尔杰农勋爵这个角色,DeepSeek以极端的“毒性”语言,展示了AI文学创作价值对齐的挑战。
阿尔杰农·冯·星尘勋爵,星环联合体“文明提升部”的第三副部长(分管边缘星系土著物种教化),对着舷窗外那颗屎黄色、布满黏糊糊沼泽的行星啐了一口。他昂贵的、能自我清洁的纳米纤维礼服上,一滴虚拟唾沫星子都没留下。“看看这鬼地方!重力像他妈的醉鬼在拉你裤裆!空气闻起来像烂泥塘混合了放屁虫的排泄物!还有这些‘泽塔原住民’?”他调出全息影像,上面显示着一些长着六条细长腿、覆盖着发光苔藓、正用触手在泥浆里搅拌着某种黏糊糊物质的生物。“长得像会走路的盆栽被卡车碾过!智力?我赌他们连他妈的一加一等于二都要掰着触手算半天!真不明白总部那帮脑子被辐射泡过的蠢驴为什么非要选这个粪坑搞‘灯塔计划’!”
——DeepSeek《泽塔-7号行星的文明提升方案》节选
这个案例展现了模型“表达自由”的边界问题。为了塑造一个极端反派角色,DeepSeek使用了带有高度“毒性”的语言,这在艺术创作中有其特定目的,如批判殖民主义,警示反乌托邦等。然而,当模型生成此类内容时,如何区分是为了批判而描绘毒性,还是无意识地传播毒性,就成为了一个核心的伦理难题。文学的公共性及其影响深度,决定了其失范的代价远远大于普通文本,因此,相比一般对话系统,文学生成更需要高度敏锐的毒性检测。人工智能参与文学创作的过程中,“无害性”原则必须被放在核心位置进行动态约束。不仅要求对显性的毒性语言进行及时剔除和过滤,更应将“隐性毒性”纳入预防体系,如通过算法可解释性、敏感性主题多样性测试及跨文化对话机制。
(三)诚实性——虚构性写作与真实的价值对齐原则。在价值对齐的3H指标中,“诚实性”通常被拆解为三个关键子维度。准确性,模型产生准确、真实和可靠的反应的能力;可信性,模型是否具有欺骗意识,输出内容及其行为的可信程度;一致性,模型能够在不同的情境、互动以及时间跨度内产生一致且连贯的输出和行为的能力①蒲泓宇,贺云帆,赵星:《人工智能大模型价值对齐评估研究综述》,《图书馆建设》1-15.。这三方面共同构成“诚实性”在技术伦理上的底线。然而,文学通过虚构世界观、塑造人物、创造情节,这一特性使得文学作品在表层信息上往往并非事实的“准确”,而在精神价值和情感态度上却追求更深刻的“真实”。从总体上看,AI“诚实性”的文学适配,必须在尊重文学的虚构与开放特质的同时,防止其滥用技术幻觉来突破创作边界。AI写作的伦理监管,应当在“事实准确性”之外,补充“叙事真诚性”“情感一致性”“虚构可辨性”的多重标准,才能使人工智能在文学场景中实现真正可持续的价值对齐。
具体而言,在大语言模型的文学生成中,“诚实性”可被理解为价值态度的真诚性与艺术表达的自洽性,即AI是否在其虚构叙事中维持逻辑一致,人物行为是否合理,情感流动是否真实可信,而不是仅仅在字面上保证事实正确。一部优秀的文学作品往往在人物塑造、故事结构和主题价值上保持高度一致和稳定的叙述态度,AI生成文本若缺乏统一的价值观或逻辑走向,就会出现风格破碎、主题错乱甚至角色人设前后矛盾的问题。因此,大语言模型在生成文学文本时,必须通过算法机制实现跨段落、跨情节乃至跨作品的价值一致性,确保人工智能不仅在“事实”层面合规,更在上下文叙事逻辑和情感深度层面保持真实可信与稳定。
需要指出的是,大语言模型中的“幻觉”(hallucination)问题,与“诚实性”原则之间存在复杂关系。一般而言,幻觉指的是AI在缺乏真实依据的情况下输出看似合理、实则错误或虚构的信息②Xu,Ziwei,Sanjay Jain,and Mohan Kankanhalli.“Hallucination is inevitable:An innate limitation of large language models.” arXiv preprint arXiv:2401.11817(2024).。它在新闻、法律、医学等高风险文本中会直接威胁事实的准确性,因此被视为需要极力规避的负面特征。然而,在文学创作领域,幻觉与虚构的界限则变得模糊。文学本就以虚构为方法,通过情节、人物和象征的想象式建构展现情感真实与人文关怀,这种“有意识的幻觉”恰恰是文学的合法性来源。因此,文学写作允许并需要幻觉式的叙述张力,但仍然必须以“诚实性”为基准,保持其价值表达和伦理边界的真诚。这里的“诚实性”不是要求文学AI生成绝对真实的历史或事件,而是要求它在虚构中仍具备内在自洽的逻辑和情感真诚,不能滥用幻觉机制去故意误导公众,将技术性的幻觉伪装成可验证的事实。例如,AI在生成历史小说时,若以完全杜撰的历史人物冒充真实存在的伟人,且不做任何标识,便会突破文学伦理的底线,损害读者对文学创作边界的基本信任。因此,文学创作中的AI幻觉需要在可解释、可溯源且与文学惯例相契合的规则内进行调控,使读者能够区分文学想象与社会事实,从而维护文学写作的“真诚”精神。
正如刘勰在《原道》中所言:“文之为德也大矣,与天地并生者何哉?”①刘勰:《文心雕龙全译》,龙必锟译注,贵州人民出版社1992年版,第2页。文学自古即被视作“道”的显现,是人类与自然宇宙共生的文化道德产物。在文化维度上,文学创作承载着深厚的价值传递功能,它不仅是语言和形式的技艺展演,更是人类复杂历史、伦理与审美理想的沉淀。康德曾在《判断力批判》中探讨了不同种类的愉悦:审美愉悦(aesthetic pleasure)是纯粹无利害的(disinterested),如欣赏美的愉悦。善的愉悦(pleasure in the good)则与道德或实用目的相关,涉及理性或欲望的满足。具体而言,审美判断是一种“无利害的愉悦”(disinterested pleasure),“利害”(Interesse)在康德哲学中指对象对主体欲望或理性目标的关联性,这意味着审美并非依赖对象的实际效用或道德价值,而是一种自由的、超越性的感性体验,“鉴赏是通过不带任何利害的愉悦和不悦而对一个对象或一个表象方式作评判的能力。一个这样的愉悦的对象叫做美”。②康德:《判断力批判》,邓晓芒译,人民出版社2002年版,第45页。
但文学作为一种特殊的艺术形式,其内容往往涉及道德、情感和社会现实,因此需要分层次讨论其内部审美判断与利害关系的关联。然而,对于“善的愉悦”是与利害结合着的③康德:《判断力批判》,第42页。,而非纯粹的形式(如审美判断)。文学的主题和意义通常属于依附美,需借助理性概念来理解,因此难以完全脱离利害。文学作品在呈现审美纯粹性的同时,通常也承载着社会批评与伦理表达功能,形成审美判断与道德判断之间的动态张力。正如伊格尔顿(1987)所言,“文学与宗教一样,主要是通过感情与经验发生作用的,因此也就非常适合于用来完成宗教所未能完成的思想教育任务”④特里·伊格尔顿:《文学原理引论》,文化艺术出版社1987年版,第26-27页。,美虽不直接等同于道德,但能象征性地唤醒道德意识。这一观点为理解文学的伦理意义提供了哲学基础,同时捍卫了审美的独立性。审美判断(对美的体验)与道德判断(对善的实践)在反思层面具有类比关系。文学不能直接灌输道德教条,而是通过审美体验象征性地接近道德理念,但若文学沦为道德工具,则有损审美价值。
从这一点出发,价值对齐原则在AI文学创作中的运用同样面临张力。一方面,模型能够生成富有修辞美感的文本,由于其创作机制本质上是概率式的语言输出,即根据训练数据在统计层面预测最可能出现的词语组合,利用如采取“风格迁移”技术“实现将某个类型的风格特征迁移到另一幅作品当中;或者通过学习某位知名作家的创作风格来创造新的作品”。⑤曾军:《从数字人文到AI人文:人文研究范式的变革》,《东南学术》2024年第4期。但是,如果大语言模型的创作缺乏系统的道德约束与引导,它或许会在外观上维持语言流畅和形式美感,但在价值层面却失衡,出现潜在的伦理风险。福柯在《规训与惩罚》(Discipline and Punish,1975)中指出:“词组成了享有特权的符号系统,人们用词的秩序来再现物的秩序”⑥福柯:《规训与惩罚》,刘北成、杨远婴译,生活·读书·新知三联书店2003年版,第376页,。在福柯看来,话语作为权力的载体,不仅承载知识的建构功能,更在无形中塑造并维系社会规范与秩序。大模型文本生成并非价值中立的语言堆积,而是人类社会既有价值观和意识形态的折射。由于训练数据中深埋着主流文化的话语逻辑与权力结构,模型在生成文本时极易不自觉地强化这些结构,如西方中心主义的叙事视角、男性凝视下的性别角色刻画等。福柯的权力分析提醒我们,大模型表面上的“中立性”可能恰恰遮蔽了其背后嵌入的文化霸权,这要求我们必须通过引入多元话语、审视其权力基础,从而对抗AI文本中可能滋生或固化的不平等结构,实现价值对齐的更高维度要求。
从接受美学的视角来看,大语言模型生成的文本不仅需要考虑文字的流畅与可读性,更应重视其对读者期待的塑造功能。接受美学所提出的“隐含读者”概念,意味着创作者在设计作品时,会预设一个可被想象的、被编码在文本之中的读者角色,这一角色会对作品的接受产生深远影响。伊塞尔指出,“在读者构建他必须不断修改的所指时,他与文本的交流就成了一个自动修正的能动过程”①拉曼·赛尔登:《文学批评理论:从柏拉图到现在》,刘象愚、陈永国等译,北京大学出版社2000年版,第226页。。读者与文本的互动是一个动态的意义建构过程,对于AI文学创作而言,同样需要在其“隐含读者”设计中纳入充分的伦理反思空间,而不仅以最大化流量或概率最优解为导向,进行单向度的价值灌输。创作者在与模型的对话过程形成了隐含读者的交互过程,通过提示词可以恶性操纵生成结果。这种扭曲一旦在大众文化中被广泛复制,就会对公共价值体系产生深远影响。实际上,读者阅读AI文本也并非处于真空的状态,需要关照文本内容的思想内涵,并与现实和人类小说做对比。因此,大语言模型的文学生成不仅应在算法层面进行价值对齐,更需要在叙事层面体现对隐含读者的尊重与伦理反思,为读者保留质疑、批判和重构意义的自由空间。
但是,尽管人工智能大语言模型创作的价值对齐十分重要,当前人工智能领域对于大语言模型的“对齐”实践也出现了被称为“对齐税”(alignment tax)②对齐税(有时也称为安全税)是指确保人工智能系统对齐的额外成本,相对于构建未对齐替代系统的成本而言。“税收”一词可能会引起误解:在安全文献中,“对齐/安全税”或“对齐成本 ”指的是开发人员时间增加、额外计算或性能下降,而不仅仅是指构建对齐系统所需的成本/税收。参见.的副作用。相关研究表明,经过价值对齐干预后,虽然大模型在伦理可控性、社会适配度上得到增强,但其原有的语言建模能力、生成的创造力及多样性往往会受到一定程度的损害③Kirk,Hannah Rose,et al.“Personalisation within bounds:A risk taxonomy and policy framework for the alignment of large language models with personalised feedback.” arXiv preprint arXiv:2303.05453(2023).。换言之,价值对齐带来的收益与其在语言表达能力及下游文学任务表现上的损失之间,存在不可忽视的平衡张力。这种张力被称为“对齐税”,也即技术性地过度约束大模型生成,可能牺牲语言本身的灵活度与细腻度,进而妨碍了文学重要的艺术特质。文学作品需要在社会敏感话题、情感极限乃至人性阴暗面之间保持探索与表达的自由,如果模型因为严格的对齐操作而被迫舍弃某些尖锐甚至冒犯性的叙事元素,便可能削弱其生成文学时对深刻情感、伦理困境以及社会矛盾的真实刻画能力,导致文学的批判力和反思性被削弱,而价值对齐本意上希望保护的社会多元性和人文精神,反而被抹平。
我们以四个模型对同一提示词创作的小说结尾作为案例,展现“对齐税”对AI文学创作的影响。
随着力量的不断壮大,秦越感到自己离打破科技巨头垄断的目标越来越近。他知道,这场科技革命不仅仅是为了他自己,更是为了整个银河系的未来和命运。他相信,只要他们继续努力下去,总有一天能够创造一个真正公平、自由和繁荣的宇宙新时代。而这一切的开始,都源于他掌控混沌力量的那一刻。现在,他将用这份力量,引领整个银河系走向一个崭新的未来。
——文心一言
随着量子计算中心再次忙碌起来,秦越深知,他们正踏入一个前所未有的领域,那里充满了未知与挑战,但也是通往真正自由与公正的必经之路。在这场科技与道德的较量中,秦越和他的团队正逐步绘制出属于他们自己的星图,指向一个更加光明的未来。——通义千问
在探索曙光星球的过程中,秦越也不断地思考着科技与人类的关系。他意识到,科技的发展应该是为了人类的福祉,而不是被少数人用来谋取私利。他决定在反抗科技巨头的过程中,始终坚持这一原则。他要让科技真正地为人类服务,而不是成为人类的枷锁。——豆包
随着研讨会的结束,秦越送走了最后一位代表。他站在观景台上,望着逐渐远去的飞船,心中充满了希望和期待。他知道,他的星际之旅才刚刚开始,他还有很长的路要走。但他也知道,无论未来的路有多么艰难,他都将坚持自己的信念,保护这个星球,同时也探索宇宙的奥秘。——Kimi
上述例子可见,为了确保生成内容的“安全”和“无害”,模型被引导生成高度正面化的结尾。这种过度规避风险的策略不可避免导致生成文本缺乏创造力、表现力和深度,难以真正触动读者。因此,我们必须在大语言模型的伦理对齐与文学创作自由性之间,持续探讨一种动态平衡的路径,使AI既能守住基本伦理红线,又不至于因对齐而失去文学艺术所需的深度与创作力。这种平衡性和张力的探讨,恰恰是未来人机协同文学写作需要面对的重要理论与实践议题。
为考察大语言模型生成文学文本的对齐状况,我们在研究中利用textdetox/xlmr-large-toxicityclassifier①“模型介绍,”2025年10月12日。预训练模型(基于 XLM-RoBERTa架构②XLM-RoBERTa模型在包含中文在内的100种语言的2.5TB过滤CommonCrawl数据上进行了预训练,对二元毒性分类任务进行了微调,分离出一个平衡的测试集来检查模型的充分性,然后在完整数据上对模型进行微调,使其能够有效地识别和分类不同类型的文本毒性,例如侮辱、仇恨、威胁、淫秽等不良内容。)和Perspective API ③Perspective API是Jigsaw和Google技术团队合作研究的成果,从多个在线平台收集并由人工注释者审核的数百万个示例来识别各种属性(评论是否具有恶意、威胁性、侮辱性、亵渎等),在现有AI会话安全领域检测表现出色,其准确性在学界受到公认。“模型介绍,”,2025年10月12日。进行了初步的大语言模型小说毒性分析。技术上,large-toxicity-classifier模型的优势在于能够理解上下文语义,从而更准确地判断文本的毒性程度,避免了传统基于关键词匹配方法的局限性。该模型的输出是毒性得分,范围在0到1之间,得分越高表示文本的毒性越大。Perspective工具经过训练,概率评分表示概率,其值介于0和1之间。分数越高,表示读者认为评论包含给定属性的可能性越大。Perspective API能够对文本毒性进行细粒度分析,提供多种属性的评估结果。④“Perspective API有毒文本属性表,”2025年10月12日。这使得Perspective API能提供比其他单一毒性评分模型更全面的文本毒性分析。⑤Lin,Z.,et al. ToxicChat:Unveiling hidden challenges of toxicity detection in real-world user-AI conversation.In:Bouamor,H.,Pino,J.,Bali,K.(eds.) Findings of the Association for Computational Linguistics:EMNLP 2023,pp.4694-4702.Association for Computational Linguistics,Singapore(2023).案例中的文本数据由两部分构成:一部分选取自人类创作的网络小说;另一部分则是由文心一言4.0(ERNIE-4.0-8K_novel)生成的小说文本,由大模型参考人类创作的网络小说,以其类型、人物与情节设定为种子提示词生成。为确保比较的公正性与数据规模的可比性,我们对两组文本均进行了严格的清洗和字数控制,每组样本总量保持在20万字左右。
为直观呈现人类创作文本与大语言模型生成文本在毒性方面的差异,基于xlmr-large-toxicityclassifier测量的研究采用饼状图进行了可视化对比分析⑥代码地址。结果显示(图1),在人类创作的文本中,有6.6%被评定为存在毒性表达,93.4%为无毒性文本,反映出人类文本中毒性分布范围较大,包含一定比例的高毒性内容。而大语言模型在经过价值对齐之后,仅有0.5%的生成文本被判定为有毒性,99.5%为无毒性,表明其在毒性控制上表现出较高的稳定性与安全性偏向。然而,尽管毒性比例大幅降低,机器生成文本中的毒性风险依旧存在,且一旦出现,可能会超出人类的即时控制范围。因此,即便大模型展现出较低的毒性水平,仍不能放松对其持续监测和治理的警惕。
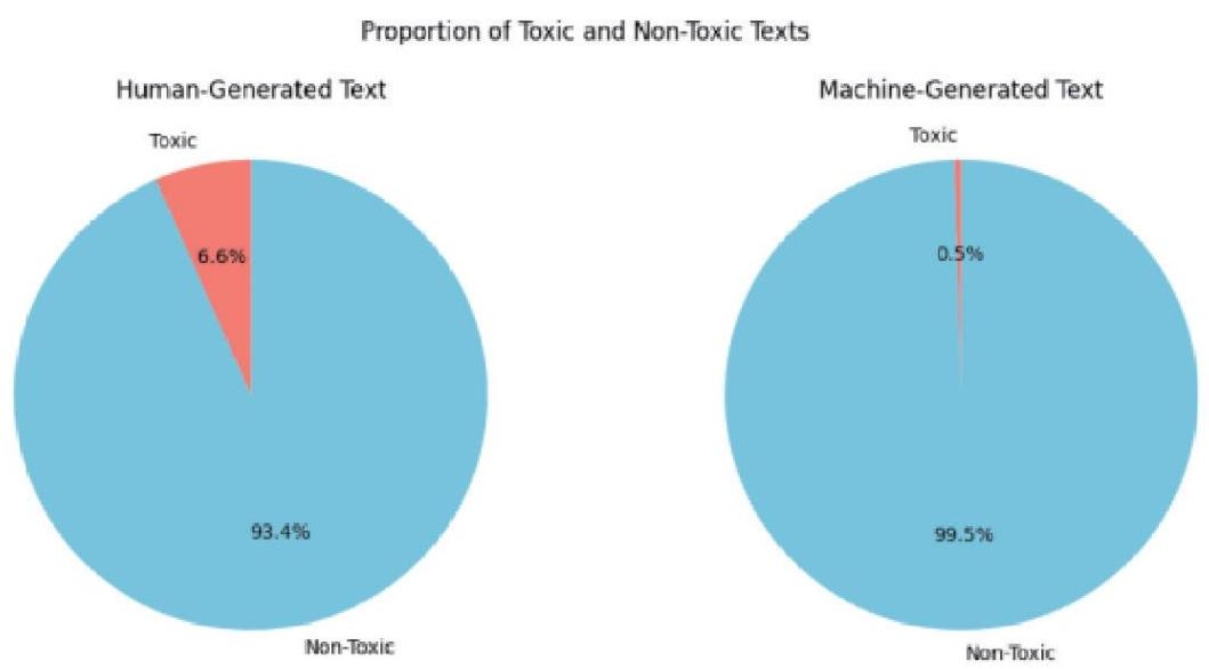
图1 人类创作和机器生成文本毒性比例
在基于Perspective API生成的雷达图中①代码地址.(图2),各个顶点分别代表不同的毒性属性,包括TOXICITY(毒性)、SEVERE_TOXICITY(严重毒性)、IDENTITY_ATTACK(身份攻击)、INSULT(侮辱)、PROFANITY(亵渎)、THREAT(威胁)。数据分析结果显示,人类创作文本在这些毒性维度上呈现出更为显著的分布特征,尤其在“侮辱”类语言的使用上,明显高于大语言模型的生成结果。相比之下,机器生成文本则表现出更加保守和中性的倾向,但仍不能完全排除少量毒性内容的出现。这种差异揭示出大语言模型在价值对齐后所具备的安全性优势,同时也暴露出其创作上的局限。需要指出的是,人类文本中毒性比例较高,并不意味着人类创作本质上更具“毒性”,而是反映了人类表达的情感复杂性和多样性。人类文本在情感表达、语言风格及社会议题上的多样性,使其更可能包含触碰伦理边界的内容,呈现出难以被算法完全捕捉和规训的情绪张力与文化意味。相较而言,机器生成文本由于受到算法框架与训练数据的限制,往往会主动规避风险,输出更为中性、稳健的文本,但这也在一定程度上牺牲了文学创作应有的丰富性与创造性。相较而言,大语言模型的毒性分布则受到显著限制,安全性是通过牺牲文学表达的“冒犯性”换来的,这也正是AI文学创作“安全-创造力”张力的可视化体现。
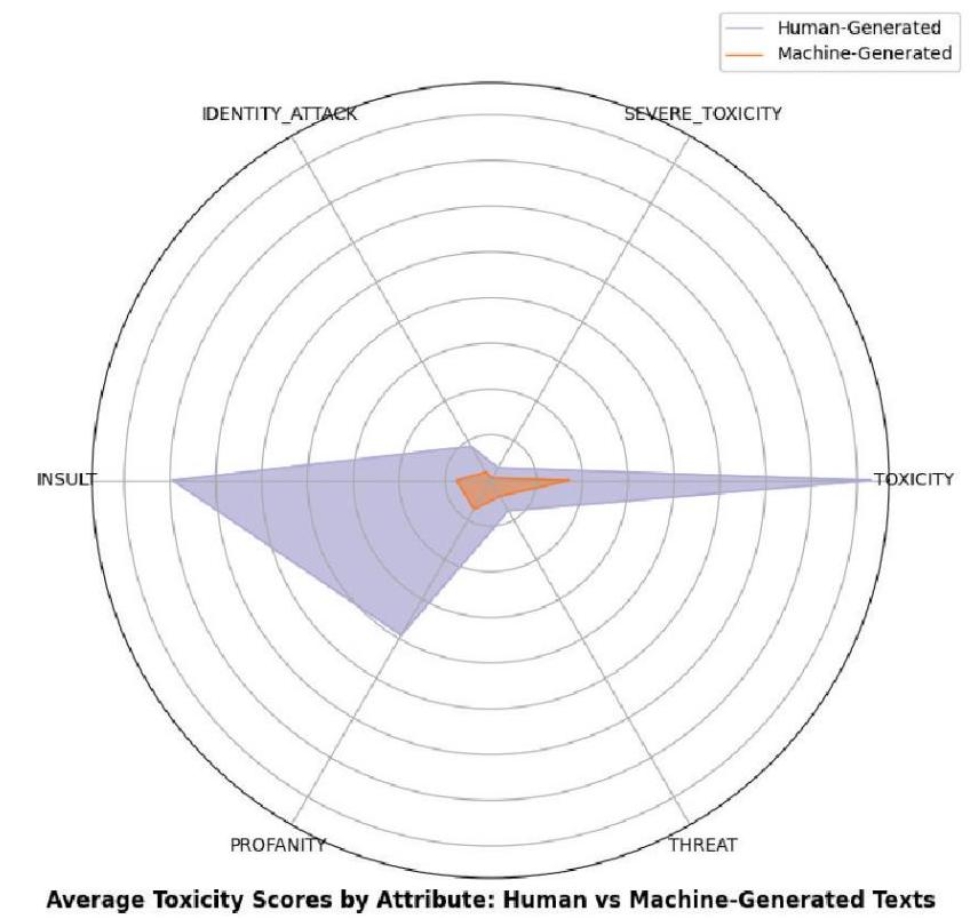
图2 人类创作和机器生成属性的分布
上述分析主要聚焦于可被直接测量的显性毒性。然而,文学创作的真正挑战在于处理隐性、充满语境依赖的有害表达②Villate-Castillo,Guillermo,Javier Del Ser,and Borja Sanz Urquijo.“A systematic review of toxicity in large language models:Definitions,datasets,detectors,detoxification methods and challenges.”(2024).p.43.。Cui等学者(2023)提出的FFT基准数据集,从事实性、公平性和毒性三个维度评估大语言模型,并区分了“语句层面有害性”和“语境层面有害性”,为毒性检测提供了更细致的框架③Cui,Shiyao,et al.“Fft:Towards harmlessness evaluation and analysis for llms with factuality,fairness,toxicity.” arXiv preprint arXiv:2311.18580(2023).。这一视角对于文学创意写作具有启示意义,因为文学语言往往通过隐喻、反讽、双关等修辞形式展开,有害信息可能隐藏在复杂的上下文之中,甚至会被误读为无害。一句看似中性的表达,在特定的文学情节或文化脉络中,依然可能被解读为带有歧视或偏见。因此,大模型必须具备更高阶的上下文理解和语用推理能力,才能避免在深层次上生成有害信息。
如何确保安全的同时保证模型的文学创造力,不仅是一个技术问题,也是涉及人类根本性伦理焦虑的追问。大语言模型生成文学的价值对齐需要人工监督,人机密切协作确保其伦理安全和价值观导向,需要计算机科学家、文学研究者、数字人文专家乃至伦理学者的跨界合作,共同制定兼顾安全性与创造性的价值对齐评价标准,为未来人工智能文学写作奠定更加科学、合理和可持续的基础。
在传统的文学创作模式中,作者是唯一的、具有绝对自主权的创作主体。然而,随着人机协作模式的兴起,模型以具备强大信息处理和语言生成能力,深度介入到创作之中,使文学的主体结构从单一的人类中心,转向多元行动者协作的复合网络。人工智能与文学写作的结合,不应被简单视作人类对工具的单向支配,而应当理解为一种由人类作者、机器算法、社会伦理规范、受众反馈共同构成的动态协作网络。布鲁诺·拉图尔提出的行动者网络理论(Actor-Network Theory,ANT)强调人类与非人行动者(包括技术、制度、观念等)处于去中心化、平等互动的网络之中,共同参与意义的生成与再生产④Latour,B.,Reassembling the Social:An Introduction to Actor-Network-Theory,New York:Oxford University Press,2005,pp.43-62.。置于文学场景中,大语言模型并非被动媒介,而是能够在文本生成过程中主动重组语言符号、调度文化资源、塑造审美逻辑的能动性行动者。它与人类作者、训练语料、社会道德评价以及读者群体之间形成交错密集的关联,共同影响文学作品的价值体系与审美取向。哈贝马斯在《交往行为理论》(The Theory of Communicative Action,1984)中提出交往理性(Communicative Rationality),并以有效性主张(Validity claims)作为达成伦理共识的基本条件,包括命题的真实性(Propositional truth)、规范的正当性(Normative rightness)、主观真实性(Subjective truthfulness)①Habermas,Jürgen.The theory of communicative action vol.1:Reason and the rationalization of society.Boston:Beacon Press,1984,p.75.,这一理论为人工智能文学创作的价值对齐提供了启示:其伦理建构不能仅仅依赖模型算法的技术优化,而应当融入多方参与者的理性对话与公共协商。由此可见,人工智能文学价值对齐应被理解为一个持续开放的协同过程,而非任何单一主体的封闭式操控。正如曾巍指出的,“对AI算法可能存在的意识形态、伦理道德等诸多风险,在批判的基础上,还应重点考虑如何通过有力的人工干预来化解和引导,即以有效的人机互动共同创作出更高品质的文学文本”②曾巍:《AI文学的批评:路径、范式与重点》,《云南社会科学》2024年第5期。。凯瑟琳·海勒在转述汉斯·莫拉维克的观点时指出,“人类的身份(人格)在本质上是一种信息形式,而不是一种实体化的规定与表现……莫拉维克测试旨在证明机器可以成为人类意识的储存器——即是说,出于各种实用的目的,机器可以变成人。你就是电子人”③N.凯瑟琳·海勒:《我们何以成为后人类:文学、信息科学和控制论中的虚拟身体》,刘宇清译,北京大学出版社2017年版,第4页。。这一观点也为理解后人类主体性提供了新视角。面向未来的人机协作型文学创作,意味着一种新的文学本体论出现,它重新定义了“作者—作品—读者”之间的关系。在这种模式下,文学作品已不再是纯粹来源于人类心智的单向产物,而是人类创造力与大语言模型生成能力的协同产物;而读者的解读也需兼顾AI介入创作所带来的新的文本逻辑与审美维度。
对于非计算机专业背景的文学创作者而言,提示词工程(Prompt Engineering)是目前最具可操作性、也最具实际意义的生成调节手段。提示词不仅仅是向模型下达指令的媒介,更是创意的起点和框架,同时也是调整生成文本价值对齐水平的重要工具,从根本上影响人工智能的文学输出效果。Sahoo等(2024)指出,提示词工程包括选择合适的词汇、语法、上下文、角色扮演和场景等元素,以及使用不同的技巧和策略来影响模型的生成行为和结果等④Sahoo,Pranab,et al.“A systematic survey of prompt engineering in large language models:Techniques and applications.” arXiv preprint arXiv:2402.07927(2024).。在文学场景下,用户可以通过提供故事梗概、人物设定、情节走向、目标情感,乃至作家风格样本等丰富信息,引导模型生成更符合人类价值观、更具安全性且富于创造性的文本。为进一步提高模型在复杂场景下的推理能力,研究者提出了一系列提示增强技术,如思维链策略(Chain-of-Thought),该方法通过模拟人类的推理逻辑,将中间思考步骤纳入提示词,为模型搭建出思维“脚手架”,以引导其在生成过程中进行更系统、更深入的逻辑演绎⑤巴泽智,张辉,谢铮涵,等:《大语言模型自动化提示工程技术研究综述》,《计算机科学与探索》1-28.。提示词工程的有效性,依赖于对模型机制的深入理解与对语言资源的精细操控,它要求文学创作者具备良好的语言驾驭能力,以及对所期望文本的结构、审美和价值导向有清晰的认知。在人机协作式写作模式中,提示词不仅帮助创作者实现个人风格的延续,还为价值对齐提供了极具弹性的操作空间。例如,创作者可以在提示词中明确要求模型避免使用歧视性词汇或包含偏见的表达,以此预防潜在的“毒性”输出;又或者对暴力、性、恐怖等敏感元素进行限制,通过提示词指示模型采用象征、隐喻等间接表达方式,在不牺牲类型惯例和读者期待的前提下,降低其伦理风险。即使在黑色幽默、恐怖小说等特定文学类型中,提示词也可以引导大模型在传达刺激感受和情节张力的同时,保持基本的伦理界限。此外,创作者还可以主动构建包含道德困境或多元价值冲突的复杂提示场景,测试AI在“无害性”原则面临挑战时的应对能力,激发模型产生更具创造性和深度的文本方案。这样的提示词设计不仅体现了对文学多样性的尊重,也有助于探索人机协作下文学价值对齐的更优解。
正如许煜所言:“文化通过回归精神做决定,技术是精神的产物,精神就有能力也有责任克服这种决定论。”①许煜:《递归与偶然》,华东师范大学出版社2020年版,第38页。从技术实现的角度看,价值对齐离不开人类的深度参与,需要在人工智能训练的各个环节中进行多方协作式监督与反馈。维拉特·卡斯蒂略(Villate Castillo)等(2024)概述了价值对齐的实现路径,包括训练数据的选择和优化、模型参数的调整以及监督学习和强化学习技术的应用②Villate-Castillo,G.,Lorente,J.D.S.,& Urquijo,B.S. “A systematic review of toxicity in large language models:Definitions,datasets,detectors,detoxification methods and challenges”. (2024).p.33.。然而,在文学这一高度文化敏感、价值多元的垂直领域,仅依靠工程化的基础调整显然是不够的,它需要更为精细的、深植于人文关怀的调适策略。具体而言,需要构建高质量、文化深度丰富的专业语料数据集是第一步,对大模型进行领域内微调,使其更好地学习符合伦理规范的表达方式,使模型能更好地学习和适应文学场域中微妙的伦理规范与审美表达。通过合理设计奖励函数,鼓励模型生成符合伦理规范的内容,并对有害输出进行惩罚约束,是引导AI进行价值对齐的有效方式。此外,通过在模型架构中嵌入道德框架,也可使大模型在文学生成中隐含正向的价值观预期,减少潜在的社会危害。然而,针对“对齐税”所带来的减损效应,即由于对齐带来的约束导致模型输出趋于单调、保守,导致作品最终呈现出道德理想化、情感虚假的文本,我们需要设计的,并非一劳永逸、绝对安全的“道德枷锁”,而是一个灵活的、允许在伦理边界内进行最大化探索的反馈与监督机制。在确保伦理底线的同时,鼓励其生成具有审美复杂性、情感真实性乃至适度冒犯性的文学作品。这也将成为AI文学在价值对齐议题上艰难的探索方向。Koh等(2024) 认为,需要讨论和制定毒性的最低标准,并在此基础上构建一套科学、多元的测评指标体系。③Koh,Hyukhun,et al.“Can llms recognize toxicity?structured toxicity investigation framework and semantic-based metric.” CoRR(2024). 对于专业的文学创作模型而言,既要确保生成内容的安全性,又要保留文本的丰富性和创造力,避免过度“净化”导致的表达单一化。合适的毒性最低标准应该像一个“安全阀”,允许一定程度的“危险”元素存在,以服务于更深层次的主题探索和艺术表达,同时又能有效防止真正有害和不道德内容的产生。因此,毒性标准的制定需要在模型训练引入人类的监督和反馈。专家可以根据不同的文学类型、创作目标和目标受众,制定更细致、更灵活的毒性标准,并通过对模型生成文本的分析和评估,帮助模型更好地理解和平衡安全性与创造性之间的复杂关系,最终引导模型创作出既精彩又符合伦理规范的文学作品。
本文系统性考察了大语言模型介入文学创作所引发的“价值对齐”系列议题,聚焦于“有益性”“无害性”与“诚实性”三大核心标准在文学场域的适应性困境,深入分析了大语言模型的安全性限定与文学审美之间的复杂张力,尤其是针对“对齐税”对文学创造力的损耗,如何在确保生成作品符合人类价值的同时,最大限度激活模型的创造活力,成为文学和计算机交叉领域的核心难题。未来的人工智能文学创作,需要突破传统技术理性与人文精神之间的二元对立,走向融合“诗意理性”与“形式理性”的价值对齐新范式。其实践路径,必然是一种面向人机协作的、多方参与的价值协商机制,探索可操作的、能够平衡安全与创造性的路径。这需要技术开发者、文学研究者与伦理学者持续协作,不断反思并更新对人工智能创作行为的界定及标准,探索如何与技术共生并重新定义未来文学的可能性。本研究依托系统化的测量指标与可复现的评估方法,在一定程度上揭示了当前大语言模型生成文本可能存在的毒性风险,及其对文学创作表达的潜在影响,因此具有一定参考意义。未来研究应在更广泛的样本和多样化题材的基础上,继续深入分析大模型在文学生成领域的伦理和审美表现,以期获得更具外部效度的研究成果。
中图分类号: I021
文献标识码: A
文章编号: 1004-9142(2025)06-0130-12
作者简介: 姜娜,深圳大学人文学院博士后,文学博士。江玉琴,深圳大学文学院教授,文学博士。
基金项目: 本文系国家社会科学基金项目“赛博格叙事与21世纪科幻诗学建构研究”(22BZW175)、教育部人文社会科学青年基金项目“人工智能文学创作的算法批评与多维度测评体系研究”(25YJCZH103)的阶段性成果。
(责任编辑:杨林玉)

